100万回のやり取りで、作り出した言葉が共有の意味を持つ
空の語彙から出発した10体の人工知能エージェントは、ブリュッセル自由大学(VUB)とベルギーのナミュール大学の研究者による実験で、100万回のやり取りを経て、最大99.76%の成功率で互いに物体を特定できるようになった。言葉と意味は、人間が作成した辞書を通じてではなく、繰り返しのやり取りを通じて発達した。
目次
研究者らは、ワインの化学測定値やNASAの系外惑星データから、鳥や人間の顔の写真まで、37の公開データセットで手法を検証した。注目された7つのデータセットでは、テスト時のやり取りにおける成功率は95.77%から99.76%だった。
中心的な成果は、物事をどう表現するかについて合意が形成されたことだ。各エージェントは、作り出した言葉と観察した特性の対応関係を個別に保持した。フィードバックを通じ、そうした個々の対応関係は、メンバーによって環境の捉え方が異なる場合でも、集団で意思疎通できるほど互換性のあるものになった。
研究論文「連続世界における創発的コミュニケーション:大規模な概念的基盤を持つ語彙の自己組織化」は、コンピューターシミュレーションでの実験について述べている。エージェントは、物体や画像の数値表現を用いた。研究者らは、この手法の応用先としてロボット、自動運転車、産業用センサーを挙げている。
言葉が役立つようになる仕組み
それぞれのやり取りには2体のエージェントが参加する。一方が話し手、もう一方が聞き手となり、やり取りを重ねるごとに役割が割り当て直される。双方が複数の対象を含む場面に遭遇するが、対象として指定されたものを知らされるのは話し手だけだ。
話し手は、聞き手がその対象を選べるような言葉を選ばなければならない。語彙に適切な言葉がなければ、新たに作り出す。論文では「demoxu」のような任意の3音節の文字列が使われており、ラベル自体にはあらかじめ意味が備わっていない。
聞き手は、その言葉を自分が保持する概念と照らし合わせて、対象を選ぶ。選択が正しかったかどうかは、両方のエージェントにフィードバックされる。失敗した場合、聞き手には対象が明かされ、それをもとに理解を修正できる。
研究者らが用意したのは、言葉を作り、概念を表現し、結果から学習するための手順だ。具体的な語彙と、それに結び付くカテゴリーは、やり取りの中で生まれた。成功したやり取りによって有用な対応関係が強まり、その後の経験によって言葉に結び付く概念が調整される。
ナミュール大学教授で共著者のカトリエン・ブールス氏は、局所的なやり取りが集団全体での合意につながる仕組みについて、大学の発表で次のように述べた。
興味深いのは、ルールを押し付ける中央コンピューターが存在しないことです。その都度、2体のエージェントが局所的なレベルで意思疎通するようにしています。こうした個々のやり取りと更新だけを通じて、集団全体にわたる共通の取り決めが自発的に生まれるのです
エージェントが意味として保持するもの
各対象は、特性を表す値の一覧である特徴ベクトルとしてエージェントに与えられる。たとえばワインのサンプルは化学測定値で表現できる。画像は、視覚システムが抽出した数値特徴で表現できる。
言葉は概念プロトタイプ、つまり、どのような観察に当てはまるかを数学的に記述したものと結び付く。プロトタイプには、典型的な値、そのばらつき、最も重要な特徴が記録される。これによりエージェントは、新たに遭遇した対象が既知の言葉にどの程度当てはまるかを判断できる。
文脈も重要だ。話し手は、場面にある他の対象よりも、対象にうまく当てはまる概念を持つ言葉を探す。そのため有用な言葉は、すべての物体に固定のラベルを付けるというより、目の前の選択肢の中から特定のものを見分ける助けとなる。
エージェントはこうした表現を個別に保持する。互いの内部設定や中央の知識ベースにアクセスすることはできない。それぞれの表現が各自の観察に基づいたままでも、言葉によって互換性のある選択が導かれることで、共有されたコミュニケーションが発達する。
画像データセットでは、研究者らは既存の視覚エンコーダーであるDINOv2による384次元の特徴を用いた。視覚エンコーダーは、画像を他のソフトウェアが処理できる数値記述に変換する。語彙の学習は、その記述を対象に行われた。
共有語彙はどの程度機能したのか
標準的な実験では、10体のエージェントから成る集団を100万回のやり取りで訓練した。その後、訓練時に使わなかった対象も含め、10万回のテスト時のやり取りでコミュニケーションを評価し、独立した10回の実行結果を平均した。
注目された7つの結果は、手法の有効性とタスク間の差の両方を示している。
- CLEVR:視覚的な物体属性を扱うデータセット、意思疎通の成功率99.76%。
- ワイン分析データ:99.76%。
- 系外惑星データ:99.67%。
- キノコデータ:98.10%。
- MS COCO画像データ:95.77%。
- CelebAの顔画像:96.66%。
- 鳥の画像:95.88%。
これらの割合は、聞き手が意図された対象を選んだ頻度を示す。ワインとCLEVRのタスクでは、99.76%はテストで1万回やり取りするごとに約24回失敗したことに相当する。MS COCOの95.77%は、1万回ごとに約423回に相当する。
この結果の差は3.99ポイントだ。注目されたタスク全体で意思疎通は高い成功率を維持したが、自然画像のデータセットでは、ワインや系外惑星のタスクよりも間違いが多かった。
研究チームは語彙の規模と、エージェントがどれだけ一貫して言葉を使うかを示す慣習の一致度も測定した。これらの指標はプロセスの異なる側面を捉える。集団が対象を確実に特定するには、実用的なラベル群と、その使い方についての十分な合意の両方が必要となる。
センサーが異なっても合意は可能
機械がまったく同じ方法で世界を観察することは、ほとんどない。センサーの較正設定は異なる場合があり、読み取り値にはノイズが含まれることもある。また、ある機器が捉えられる特性を別の機器は検出できない場合もある。研究では、こうした条件の違いを検証した。
VUBの人工知能教授で共著者のポール・ファン・エーケ氏は、人が赤い車を見分ける例を挙げて研究の動機を説明した。人によって目が捉える色の値に多少の差があっても、同じ説明を理解できる。共有される言葉は、個々の読み取り値を超えたところにある。
実験では、エージェントの観察内容を変えることで、この考え方を人工エージェントに適用した。較正差に相当する数値のずれ、観察値に加わるノイズ、利用可能な特徴の種類がメンバーごとに異なる集団が含まれた。
CLEVRの実験で強いノイズを加えた条件では、意思疎通の成功率は87.67%だった。利用可能なセンサーにさらに大きな差を設けた条件では83.47%だった。標準的なCLEVR実験より精度は低下したものの、こうした条件下でも手法は相当の協調能力を維持した。
論文では、知覚構造が異なる集団を「異形態」と表現している。簡単に言えば、メンバーが受け取る情報の種類や量が異なるということだ。各メンバーがアクセスできる観察結果を使い、そうした違いがあっても互換性のある指示表現を作ることが課題となる。
入力が失われると変化する語彙
研究者らは学習中に情報が突然失われる状況も検証した。ある実験では、センサーの読み取り値に相当する入力の半分を、プロセスの途中で取り除いた。その後の意思疎通の成功率は93.82%に達した。
やり取りを続けることで、状況の変化に合わせて概念を修正する機会がエージェントに与えられる。複数の特徴と結び付いた言葉は、その一部が失われ、残る観察結果の重要度が高まると、異なる形で役立つようになることがある。
論文は、環境の変化への適応についても報告している。継続的な学習がこの手法の中核となるのはそのためだ。集団は使用を通じて共通の取り決めを築き、観察内容が変わるのに合わせて調整を続ける。
将来の機械システムでは、機器の劣化や稼働条件の変化に対応する際に、こうした能力が重要になる可能性がある。ただし、今回の実験で示されたのは、シミュレーション内のタスクにおいてエージェントが語彙を適応させたことだ。
集団が大きいほど、やり取りの回数が必要
研究では、2体、10体、25体、50体、100体から成る集団を調べた。やり取りは引き続き個々のペア間で行われるため、集団を拡大すると、有用な言葉をより多くのメンバーに広める必要が生じる。
エージェント100体のCLEVR実験では、100万回のやり取り後の意思疎通の成功率は92.69%に達した。訓練を1000万回のやり取りまで延長すると、成功率は6.47ポイント上昇し、99.16%となった。
学習に使えるやり取りの総数を見ると、この課題の規模が分かる。参加が均等に分散すると仮定した場合、エージェント10体の集団では、100万回のやり取りに各回2体が参加するため、1体あたり平均20万回の参加となる。同じ回数のやり取りを100体の集団で行う場合、1体あたりの平均参加回数は2万回となる。
1000万回のやり取りを行うと、エージェント100体の集団でも、1体あたりの平均参加回数は20万回に戻る。個々のやり取りはランダムに選ばれるが、この比較から、集団が大きいほど慣習を広めるために、はるかに多くの学習機会が必要になる理由が分かる。
人間が言葉の指すものを調べられる
研究者らは、解釈可能性を設計上の利点として挙げている。言葉は、値や特徴の重みを調べられるプロトタイプを指す。研究者は、どの観察が概念の形成に役立ったか、その表現が使用を通じてどう変化するかをたどることができる。
化学測定項目に名称が付いたデータセットであれば、調査によって言葉を特定の測定値の範囲と結び付けられる。画像データの場合、概念は視覚エンコーダーが生成した特徴に結び付くため、その意味を説明するには、数値化された画像表現を理解する必要もある。
VUB人工知能研究所の博士課程研究者で共著者のジェローム・ボトコ・エキラ氏は、エージェント自身の知覚をもとに概念を構築させる目的について、次のように述べた。
エージェントは、人間には理解できないデータであっても、センサーを通じて知覚する内容に正確に対応した、効果的な概念を構築します
人間による監督では、こうした対応関係が形成される過程を調べることになる。有用な確認方法の一つは、入力や環境が変化した後も、同じ言葉を使う2体のエージェントが意図された対象を選び続けるかどうかだ。研究で用いたフィードバック機構では、この関係が学習の中心となっている。
発表、共同研究、応用の可能性
この研究には、VUBのジェローム・ボトコ・エキラ氏、ララ・フェアハイエン氏、イェンス・ネーベンス氏、ポール・ファン・エーケ氏と、ナミュール大学のカトリエン・ブールス氏が参加した。資金は、WEAVEプロジェクトを通じてフランダース研究基金(FWO)とベルギー国立科学研究基金(FNRS)から提供された。
VUBの論文掲載記録によると、掲載誌は『Transactions of the Association for Computational Linguistics』第14巻、2234~2257ページで、DOIは10.1162/TACL.a.799。2026年8月の掲載と記載されている。
論文の掲載と大学の発表は、次の順序で行われた。
- 2026年4月:論文を投稿。
- 2026年5月:論文を改訂。
- 2026年8月:大学の掲載記録に学術誌への掲載が記載。
- 2026年10月14日:大学が研究成果を発表。
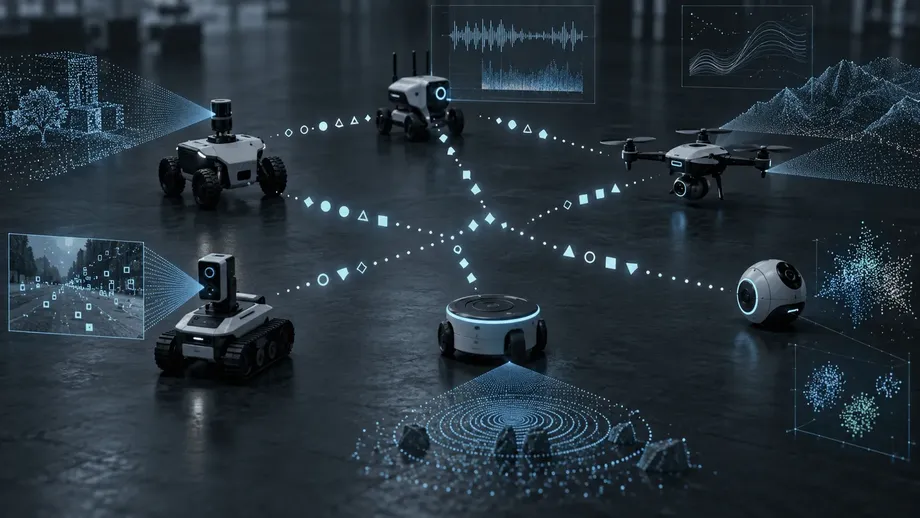
研究者らは、自動運転車、ロボット、産業用センサーを、機械の知覚に適応したコミュニケーションの潜在的な利用者として挙げている。ライダー(LiDAR)は光を使って距離を測定し、ソナーは音を使う。赤外線センサーは温度に関連する放射を検出し、化学機器は物質を測定する。共有語彙があれば、こうした入力を通じて得られる有用なパターンを機械同士で表現できる可能性がある。
次の実用化に向けた段階は、実機や変化する周辺環境、運用上の要求のもとで、こうした慣習がどう機能するかを検証することだ。導入時期は示されていない。現時点で得られた成果は、多様なデータにまたがる共有表現を構築する手法を検証し、ノイズや知覚の違い、入力の欠落がある状況で性能を測定したことだ。
要点
- VUBとナミュール大学の研究者らは、37の公開データセットを使って語彙の形成を検証した。
- 10体のエージェント集団を100万回のやり取りで訓練し、その後10万回のテストを行った。
- 注目された7つのデータセットにおける成功率は95.77%から99.76%だった。
- 研究者らが用意したのは学習手順であり、具体的な言葉と結び付く概念は、フィードバックを通じてエージェントが形成した。
- ノイズのある観察、知覚構造の違い、入力の欠落への適応を実験で検証した。
- エージェント100体の集団は、CLEVRで1000万回のやり取り後に99.16%の成功率を達成した。
- 研究ではコンピューターシミュレーションを使用した。ロボット、車両、産業用センサーへの応用は、今後の利用案として提案されている。