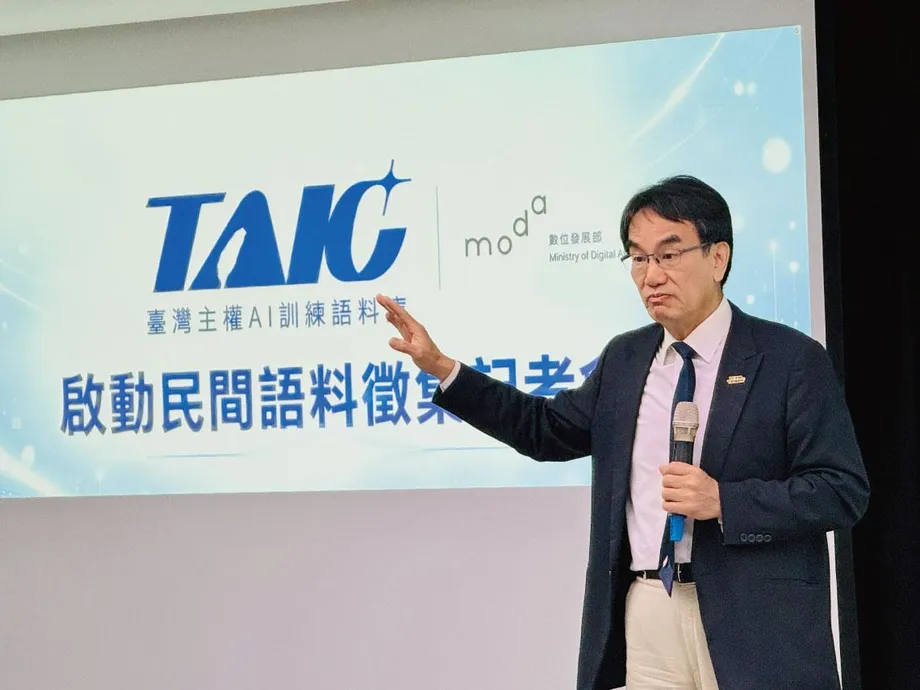
民間からの提供は111件、台湾のAI構想に課題
台湾政府のAI学習用コーパスには7,161件のデータが蓄積されているが、民間からの提供は111件にとどまる。全体の約1.6%で、人工知能(AI)に台湾の言語や文化、日常生活を理解させることを目指すプロジェクトとしては、わずかな割合だ。
目次
デジタル発展部は2025年12月24日、台湾の主権AI学習用コーパスを公開した。200を超える政府機関が、6億トークンを含む2,000件以上のデータセットを提供した。トークンとは、AIシステムが処理するテキストの小さな単位で、1文字の場合もあれば、単語の一部の場合もある。
政府機関の参加によって、コーパスの規模は拡大した。一方、出版社や著者、教育プラットフォーム、報道機関を参加させるのは、より難しい課題だ。開発者は学習に貴重な文章を複製する許可を得る必要がある一方、コンテンツの権利者は対価と作品の利用方法を管理する権利を求めている。
2026年10月14日の立法院公聴会で、林宜敬デジタル発展部長は、民間の参加は任意だと説明した。また、特に米国企業を含む大手AI企業に対し、学習用コンテンツの利用料を支払ってほしいとの考えを示した。報道コンテンツは、現在の民間向け収集プログラムの対象外だ。
実際に問われているのは、データベースの規模だけではない。台湾の文章で学習したモデルは、地域の語彙を身に付け、文化的伝統を説明し、台湾の制度を踏まえて質問に答えられるようになる可能性がある。しかし、その素材を生み出す著者や組織も、作品の商業的価値に依存している。台湾は、誰が費用を負担すべきか、許諾がどこまでの利用を認めるのか、著作権規則のどの部分を明確にする必要があるのかを検討しながら、作品の利用機会を広げようとしている。
政府のコーパスに含まれるもの
デジタル発展部の公開発表によると、コーパスは言語、文化、教育、生物、地理を網羅している。10年以上にわたる政府オープンデータを活用し、利用者はデータを検索してダウンロードできる。
文化部は公共芸術や文化資産に関するデータセットを提供した。教育部は台湾語、客家語、標準中国語を網羅した辞書データを提供した。こうした資料は、場所や物、伝統に関する情報とともに、地域特有の意味や用法について開発者に学習素材を提供する。
デジタル発展部のコーパス事業の説明では、原住民族委員会と客家委員会も参加機関として挙げられている。歴史、文化遺産、観光、地域文化などを扱う計画だ。同部は、有用な学習用テキストには一貫性と完全性があり、流暢であることが必要だとしている。
2026年9月に立法委員へ示された数字によると、コーパスには5,000件を超えるデータセットがあり、トークン数は24億を上回った。公開時に発表された6億トークンと比べると、トークン単位で測ったテキスト量は4倍以上に増えたことになる。7,161件のデータと民間提供分111件は、コーパスの構成を示す別の指標だ。
地域の言語が重要な理由
コミュニティー知識プロジェクト「Taiwan.md」を立ち上げたニューメディアアーティストの呉哲宇氏は、主流のAI学習における繁体字中国語の比重が小さすぎると指摘する。同氏は自らのプロジェクトを説明する際、中国語の学習素材に占める繁体字の割合は1%未満だとの推計を示している。
呉氏が懸念するのは、簡体字を繁体字に置き換えることだけではない。台湾と中国では日常的な物の呼び方が異なる場合があり、同じ表現でも意味が違うことがある。地域の知識には制度や歴史、食文化も含まれる。タピオカミルクティーや小籠包ほど国際的に知られていない料理もその一例だ。
Taiwan.mdはAIツールを使ってウェブ上の情報を集め、台湾の自然、社会、歴史に関する記事を編集している。記事は1,123本で、一般公開されている学術論文やブログ、政府情報を活用する。呉氏は、ChatGPT、Gemini、Claudeなどの主流モデルが台湾の経験を反映した文章に触れる機会を増やしたいと考えている。
政府は、台湾が自らのニーズに沿って形作れるAIの資源と能力を開発する構想を「主権AI」と呼んでいる。同コーパスは学習素材を提供し、Taiwan.mdのようなプロジェクトは、AI開発者が地域の知識を見つけやすくすることを目指す。
刑事告訴で変わった判断
2025年7月、台湾大学の博士課程の学生が、無許可の中央通信社(CNA)記事14万本を含む繁体字中国語コーパスを配布したとして、著作権侵害の刑事告訴を受けた。学生はオープンな資料を掲載する米国のウェブサイトから資料を集め、無償でコーパスを共有していた。
その後、当事者間で和解が成立した。学生は謝罪し、研究者にデータの出所が適法か確認するよう呼びかけ、コーパス全体を削除した。
呉氏によると、この事例を受け、独立系開発者はより慎重になっている。Taiwan.mdのチームは著作権上の問題がありそうな資料を除外しており、コーパスの拡充が遅れている。小規模なプロジェクトにとって、刑事手続きに発展する可能性は、許諾の確認が難しい作業に個人的なリスクを加える。
問題の経緯は、いくつかの日付からたどることができる。
- 2023年初め:国家科学及技術委員会が2億台湾ドル超の資金を投じ、TAIDE言語モデルプロジェクトを開始。
- 2025年7月:無許可の報道記事を含むコーパスを巡り、博士課程の学生が告訴を受ける。
- 2025年12月24日:デジタル発展部が6億トークンを収録した主権AIコーパスを発表。
- 2026年9月:同部の発表によると、データセットは5,000件を超え、トークン数は24億を上回る。
- 2026年10月14日:林部長が立法委員に対し、民間からの提供は任意であり、有償のコンテンツ契約を目指すと説明。
AI学習と著作権
鹿国法律事務所の上席弁護士、陳啓東氏は、複製が法律上の中心的な論点だと指摘する。開発者は一般に、モデルの学習に使う前にテキストを複製する必要がある。著作権法は、フェアユースなどの例外を除き、権利者に複製を管理する権利を認めている。
フェアユースは、一定の状況下で、許諾を得ずに著作物を利用することを認める制度だ。陳氏によると、台湾の現行規定はAIの学習を明示的に扱っておらず、裁判所がその利用を認めるかどうか、開発者には見通しが立たない。
学習と回答の生成では、行われる行為も異なる。学習段階ではシステムが例文を処理し、パターンを学ぶ。生成段階では、利用者に向けたテキストを出力する。陳氏は、著作権で保護された作品に酷似する出力のリスクも含め、両段階を分けて法律で扱うことを提案している。
経済部知的財産局は、法改正の可能性について引き続き検討中だとしている。デジタル発展部によると、著作権政策を所管するのは同局だ。監察院の調査も、行政院が同局に課題を割り当てた後、法的枠組みの見直しに積極的に取り組むよう促した。
所有権の移転ではなく、任意の許諾
林部長は立法院交通委員会で、民間向けのコーパス事業は出版社と電子書籍プラットフォームから始めると述べた。求めている資料として、次の4種類を挙げた。
- 著作権の保護期間が終了した書籍。
- 出版社が提供する書籍の紹介文。
- 書籍から選んだ試し読み用の文章。
- 個人の著者が任意でライセンスを付与する作品。
林部長は、AI学習での作品利用許諾を求めており、著作権の所有権は著者に残ると説明した。ライセンスは合意した条件のもと、特定の行為を他者に認めるものだ。許諾される用途や期間などを定めることができる。
民主進歩党の林楚茵立法委員は、提供者への報酬の仕組みや、後に許諾を撤回した場合の扱い、学習から別の製品が生まれた際に利益をどう守るのかをただした。台湾民衆党の洪毓祥立法委員は、品質確認や権利処理、有償での取得、さまざまなライセンス区分の管理を担うサービスを提案した。
同部は「台湾主権AI学習用コーパス・ライセンス第1版」を公表し、各機関が適用する際の事例を知的財産局と共同で作成した。標準的な条件を設ければ、交渉の繰り返しや著作権紛争を減らせる。同部は提供を促すインセンティブも計画している。公表された提案では、支払額や許諾撤回の取り決め、学習から生まれた製品に関する規則は、まだ決まっていない。
有償での協力に先例
オープンカルチャー基金会の李柏鋒理事長は、出版社に貴重な資料を無償で提供するよう求めても、十分な参加は得にくいと述べる。交渉による交換条件を通じて、メディアや教育プラットフォームの協力を得た小規模な学習プロジェクトを例に挙げた。
条件には、一度限りのライセンス料、データ利用期間を2年間に限定すること、参加したコンテンツ提供者が完成したモデルを優先的に利用できることが含まれていた。提供者は金銭を受け取り、利用期間が明確になり、見返りとして有用なものも得た。
遠流出版の王栄文董事長も、政府と民間の開発者はコンテンツのライセンス料を予算に計上すべきだと主張する。刑事告訴への不安が、民間開発者だけでなくAIプロジェクトを支援しようとする当局者にとっても制約になっているとみる。
林部長は立法委員に対し、大手AI企業に有償でコンテンツを提供することが政府の最終目標だと述べた。新技術を巡る著作権紛争は3~5年続く可能性があるため、同部はまず紛争の少ない資料から取り組んでいるという。この期間は論争が続く可能性を示したもので、法整備や料金制度の期限を示したものではない。
法的例外と集中管理ライセンス、二つの選択肢
陳氏は、台湾の著作権法にAIを扱う専用の章を設けるよう提案する。テキスト・データマイニングの例外を定め、学習データの出所開示を義務付け、条件を満たす利用が刑事手続きの対象となるリスクを軽減する内容だ。
テキスト・データマイニングとは、ソフトウェアを使って大量の資料を分析し、パターンを見つけ出すことをいう。欧州連合(EU)、日本、シンガポールには、一定の形式の活動を認める例外規定があるが、規則や条件はそれぞれ異なる。陳氏は、台湾での議論にあたり、こうした制度が参考になるとみている。
李氏は、より早い行政措置として、どのような学習利用を当局がフェアユースとみなし、どのような利用に侵害のリスクがあるのかを示す指針を提案する。開発者やクリエーターにとって当局の見解を実務に生かしやすくする例として、日本の文化庁が2024年に公表した「AIと著作権に関するチェックリスト&ガイダンス」を挙げた。
陳氏はまた、台湾音楽著作権協会(MÜST)をモデルにした集中管理ライセンスを提案する。この仕組みでは、団体が多数の権利者に代わって許諾を管理し、使用料を徴収して分配する。AI向けに同様のサービスがあれば、何百もの出版社や著者と個別に交渉する負担を減らせる。
国立台北科技大学知的財産研究所の兼任助理教授、張崇信氏は異なる見解を示す。法改正を求めるのではなく、現行の著作権規則に基づき開発者が対価を支払うべきだと主張する。貴重な出版物や報道コンテンツを交渉によって利用することが、解決策の中心になるとの立場だ。
TAIDEが示す、利用機会と資源の重要性
台湾の先行プロジェクト「信頼できるAI対話エンジン(TAIDE)」は、モデルが少数の利用可能なデータ群にいかに大きく依存し得るかを示している。国家科学及技術委員会のプロジェクトとして2023年初めに発足し、初期開発には2億台湾ドルを超える資金が投じられた。
TAIDEは15の政府機関から学習素材を集めた。中央通信社の記事約400万本がテキストデータの70%を占めた。著作権上の問題に配慮して素材が集められたことは、規模の大きい報道アーカイブを組織的に利用できることが、地域に根差したモデルの支えになると示している。
台湾中央研究院の台湾情報セキュリティセンター(TWISC)の主任研究員、李育杰氏は、国内に代替手段を持つ意義を次のように説明した。
当初は大規模なエンジンに対抗できないかもしれません。しかし、自前の対話エンジンがあれば、少なくとも選択肢を持てます
初期モデルはMetaのLlama 2を基盤とし、70億のパラメーターを備えていた。パラメーターとは、学習中にモデルが調整する数値設定だ。国家高速網路与計算中心は1,028基のV100画像処理装置を保有し、通常業務を続けながら、プロジェクト向けに2023年11月にH100を9基購入した。
国立中興大学の農業分野の質問応答プロジェクト「Demeter GPT」は、その後ChatGPTからTAIDEに切り替えた。范耀中准教授は、追加学習によって中国語の精度が向上したと説明した。研究室は以前、OpenAIに回答1件当たり1~2台湾ドルを支払っていた。TAIDEをローカル環境で動かすようになり、運用費は自前のコンピューターと電気代に移った。
台湾のコーパス構想は、こうした用途を支えるテキストの供給に取り組んでいる。政府の辞書や文化記録が基盤となる。出版物や専門的な教材、報道へのアクセスをさらに広げるには、開発者が支払える金額で、コンテンツの権利者も受け入れられる合意が必要になる。
要点
- コーパス7,161件のうち、民間からの提供は111件で、約1.6%にとどまる。
- 政府は2025年12月の公開時に6億トークンを発表し、2026年9月には24億を超えた。
- 林部長によると、民間の参加は任意で、著作権の所有権は著者に残る。
- 報道コンテンツは現在の民間向け収集プログラムの対象外だが、同部はAI企業との有償契約を目指している。
- 無許可の報道記事14万本を巡る2025年7月の刑事告訴で、独立系開発者の懸念が強まった。
- フェアユースの指針明確化、データマイニングの例外規定、集中管理ライセンス、現行法に基づく直接支払いなどが提案されている。