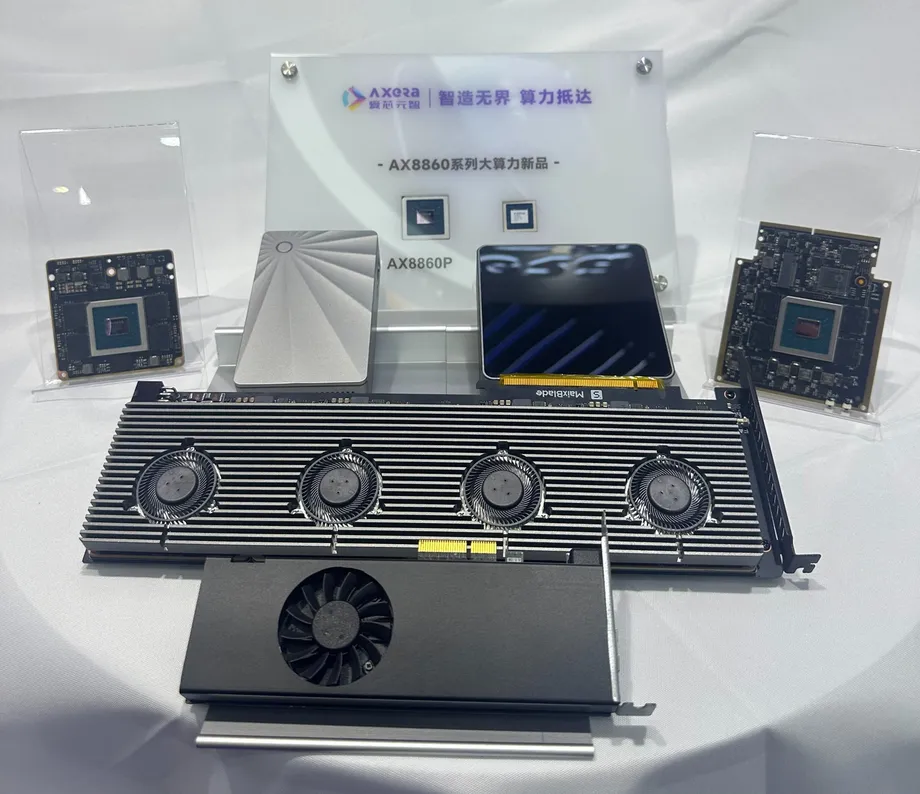
中国製の小型AIコンピューター、高価格の競合に挑む
Sipeedは、中国の半導体メーカーAxeraの「AX8860P」を搭載した、メモリー128 GBのコンピューター「MaixStation」の価格を約3,999ドルとすることを目指している。サイズはわずか11×11×3 cmで、一般的な消費電力は40ワット。大規模AIモデルをローカル環境で実行できるとうたう。競合として想定しているのは、メモリー128 GBで約6,950ドルの小型AIシステム、Nvidiaの「DGX Spark」だ。
目次
Axeraは2026年10月13日、上海で開かれた産業展示会でこのチップを発表し、Sipeedも同時にMaixStationを披露した。当初の訴求は強気だった。パラメーター数270億のQwenモデルを動かした場合、DGX Sparkに比べてプロンプト処理が25%速く、回答生成が30%速い一方、価格はおよそ半分とした。
SipeedのMaixStation製品ページには現在、より詳しい情報が掲載されている。Qwen3.8-27Bのプロンプト処理速度は毎秒592~677トークン、回答生成速度は毎秒6~7トークンとしている。いずれも発表時に出回った数値を下回る一方、正式な発売計画では2026年末にKickstarterキャンペーンを実施する予定だ。
この製品の魅力は明確だ。小型コンピューターに大容量メモリーを搭載すれば、開発者やオフィス、個人ユーザーはクラウド計算を借りたり、複数のグラフィックスカードを購入したりせずに、高性能なモデルを動かせる可能性がある。ただし、購入判断を左右するのはチップの仕様だけではなく、最終的なソフトウェアや実測性能、納期も同様だ。
AX8860Pに搭載された技術
AX8860シリーズは6ナノメートルの製造プロセスを採用し、Arm Cortex-A55 CPUコア16基と専用のニューラル処理装置(NPU)を組み合わせている。NPUは、AIモデルで使われる反復的な計算を実行するために設計されたプロセッサーだ。AxeraとSipeedは、FP4で最大毎秒256兆回の演算性能をうたっており、これは一般に256 TOPSと表記される。
FP4は数値を4ビットの精度で保持する形式だ。ビット数を減らすとモデルに必要なメモリーを抑え、計算を速められるが、モデルとソフトウェアがこの形式に対応している必要がある。Axeraの数値は密な計算に基づくもので、スパース性と呼ばれる手法で一部の値を省略できると仮定した計算ではない。
チップはPCIe 5.0と、幅256ビットのメモリーインターフェースに対応する。SipeedはLPDDR5X-8533メモリーを仕様に掲げ、モジュール当たり最大128 GB、帯域幅は毎秒273 GBとしている。Maix-Vモジュールのサイズは78×78 mmで、LPCAMM2コネクターを採用する。
Cortex-A55コアはOSや補助的な処理を担い、NPUは主なAI処理を担当する想定だ。NvidiaのDGX Sparkには、より高性能なCortex-X925コアを含むArmコアが20基搭載されている。一方、競合するAMD Ryzen AI HaloシリーズはZen 5 CPUを採用する。AI推論と負荷の高い一般的な計算処理を組み合わせる予定のユーザーは、アクセラレーター以外にも比較すべき点がある。
公称TOPSより128 GBのメモリーが重要な理由
言語モデルには、学習で得た知識を符号化する数値の重みと、要求への回答中に生じる作業データを保持するメモリーが必要だ。高速なアクセラレーターでもメモリーが足りなければ、モデルを複数のデバイスに分割したり、低速なストレージを介して読み込んだりしなければならない。
MaixStationが予定する128 GB構成は、メモリー容量で上位機種のDGX Sparkと同じクラスに入る。どちらも帯域幅は毎秒273 GBとしている。AMDのRyzen AI Haloシリーズには、毎秒約256 GBで128 GBを搭載する構成と、毎秒273 GBで192 GBを搭載する上位構成がある。
容量はどれだけのデータを収められるかを決め、帯域幅は情報をどれだけ速くプロセッサーへ送れるかを決める。密な言語モデルで通常の生成を行う場合、新しいトークンを1つ生成するたびに大量のモデルデータを読み込む必要がある。トークンとはテキストの小さな単位で、単語の場合もあれば、単語の一部にすぎない場合もある。
そのためSipeedは、メモリーを効率的に使えば、同社の256 TOPSプロセッサーでもNvidiaが公表するより大きな演算性能に対抗できると主張する。DGX SparkのFP4性能は約1,000 TOPSだが、これはスパース性を利用した数値で、密なFP4演算では毎秒約5,000億回となる。実際のアプリケーション速度は、ソフトウェアがハードウェアをどれほど効率よく稼働させるかにも左右される。
公式ベンチマークページが示す、より限定的な性能
Sipeedはテストを、モデルがユーザーのプロンプトを処理する「プリフィル」と、回答を生成する「デコード」に分けている。プリフィルが速ければ、特に長い文書を扱う際、回答が始まるまでの待ち時間を短縮できる。デコードが速ければ、生成開始後に回答がより速く表示される。
Qwen3.8-27Bを密なFP4で動かした場合、公式ページはMaixStationのプリフィルを毎秒592~677トークン、DGX Sparkを550トークンとしている。これは約8~23%の優位に当たる。MaixStationのデコード速度は毎秒6~7トークンだが、公式チャートの掲載内容には、このモデルにおけるDGX Sparkのデコード速度が数値で示されていない。
専門家混合(MoE)モデルのQwen3.6-35B-A3Bについて、Sipeedはプリフィル速度をMaixStationが毎秒2,664~3,256トークン、DGX Sparkが2,368トークンと掲載している。計算すると、優位は約13~38%となる。デコード速度は毎秒34~37トークン対34トークンで、同等から約9%の優位までの幅がある。
専門家混合モデルは、各トークンの処理でネットワークの一部だけを稼働させる。そのため、総パラメーター数が同程度の密なモデルより生成速度が大幅に高くなる場合がある。両者では、トークンごとに必要な処理量が異なる。
Sipeedは公表した結果を、現時点での控えめな測定値と説明し、AX8860Pはなお調整中だとしている。チャートでは、マルチトークン予測(MTP)を無効にしたFP4を指定している。MTPは複数の後続トークンをまとめて予測し、生成を高速化する手法だ。
初期の速度主張は慎重に比較する必要がある
Sipeedが以前公表したベンチマークの範囲は、より高い数値だった。Qwen3.8-27Bのプリフィルは毎秒1,400~1,600トークン、デコードは15~17トークンで、DGX Sparkの基準値はそれぞれ1,300と13だった。専門家混合モデルでは、プリフィルが毎秒6,300~7,700トークン、デコードが80~88トークンで、DGX Sparkはそれぞれ5,600と80だった。Sipeedはその後、両段階でMaixStationが約10%上回るという比較も公表し、さらに大きな差を示す新しい測定結果については、公式の数値ではないと説明した。
公式ページで絶対値が低くなったことで、テスト条件が特に重要になっている。プロンプトの長さ、同時処理する要求数、数値形式、実行ソフトウェア、ドライバーのバージョンはいずれも結果を変え得る。報道で引用されたDGX Sparkの独立テストでは、投機的デコードを使わないQwen3.8-27Bの生成速度は毎秒約11.5~11.6トークンに達した一方、プリフィルはソフトウェアによって毎秒840~1,900トークンの幅があった。
簡単なメモリー計算をすると、先に示された毎秒17トークンという主張が注目された理由が分かる。実行中のモデルが約16 GBを占める場合、毎秒273 GBを16 GBで割ると、ほかのメモリー通信を考慮する前の理論値は毎秒約17トークンとなる。この速度を達成するには、公称帯域幅を極めて高い効率で使う必要がある。
ここではモデルが実際に占めるメモリー容量が重要だ。27億ではなく270億のパラメーターに4ビットを掛けると、重みだけで約13.5 GBになる。数値のスケーリング情報などを加えると、必要な作業領域はさらに増える可能性がある。詳細で再現可能なテストがあれば、購入検討者は速度の数値を特定のモデル構成と結び付けて判断できる。
ポケットサイズの筐体に標準ストレージ
MaixStationの公称寸法から計算した体積は363立方センチメートルとなる。SipeedはDGX Sparkの1,125立方センチメートルと比較し、予定する筐体の体積はその約3分の1としている。同社によると、65ワット対応の適切なモバイルバッテリーからUSB-C経由で給電できる。
公式ページによると、一般的な消費電力はMaixStationが40ワット、DGX Sparkが120ワット。これはSipeedが示す標準的な負荷時の数値だ。AX8860の発表時の報道でも専用モジュールの消費電力は40ワットとされており、将来の検証では、どの範囲を対象にした電力測定なのかも確認すべき点となる。
接続端子には、10G SFP+ネットワーク、USB-C、MCIO 8iコネクター、SSD用の標準的なM.2 2280スロットが含まれる。標準的なストレージ形式により、モデルファイルの保存用に容量を追加しやすい。モデルファイルは数百GBをすぐに消費することがある。
Axeraのハードウェア計画は小型デスクトップにとどまらない。モジュール、チップ1基を搭載するPCIeカード、チップ4基とファン4基、8ピンの標準電源コネクターを備えたカードなどが設計に含まれる。SipeedはMaixStation ProとMaixBladeについて、512 GB以上のメモリーを備える構成を予定している。
チップ増設で容量拡大をうたう一方、性能向上は未検証
Sipeedによると、MaixStationは外部スイッチなしで最大8台のノードを接続できる。チップ間接続の帯域幅は毎秒256ギガビットで、毎秒384ギガビットまで拡張可能としている。DGX Sparkはシステム間接続に毎秒200ギガビットを使い、4台構成には外部スイッチが必要となる。
ギガビットとギガバイトの違いは重要だ。毎秒256ギガビットの接続は、オーバーヘッドを除くと毎秒32ギガバイトに相当する。毎秒273ギガバイトというメモリー帯域幅は別のもので、各マシン内部にある、はるかに高速な接続を指す。
Axeraはチップ2基で合計512 TOPS、4基で1,024 TOPSとし、約80%のスケーリング効率をうたっている。ただし、4チップのスケーリング性能は研究室でのシミュレーションに基づく。複数のプロセッサーにモデルを分割すると、通信や同期の処理も発生するため、アプリケーションの速度はピーク演算性能を単純に合算した値だけでは決まらない。
Axeraのロードマップには、最大500 TOPSのAX8950と、700 TOPSを超えるAX8970が記載されている。これらのプロセッサーは将来のアップグレードに役立つ可能性があるが、MaixStationが当面提供する価値はAX8860Pとそのソフトウェアにかかっている。
日常的な利用ではソフトウェアが鍵
SipeedはLinux 6.18を搭載したDebian 13に加え、vLLM、SGLang、PyTorch、llama.cpp、Ollamaに対応するとしている。これらのツールは、モデルの読み込み、要求の処理、AIアプリケーションとハードウェアの接続に使われる。同社はOpenAIやAnthropicと互換性のあるAPIも掲げており、既存のアプリケーションからローカルデバイスに要求を送信できる。
Sipeedの製品FAQは、よく知られたフレームワーク名の下でAxeraハードウェア向けのソフトウェアが動作すると説明している。
SGLangとvLLMは、AXDSLで記述したカーネルを用いる独自のハードウェアアクセラレーション・バックエンドを通じて動作します。
カーネルとは、アクセラレーター上で中核となる計算を実行する小さなソフトウェアだ。Sipeedによると、対応するHugging Faceモデルはそのまま読み込める一方、新しいモデルアーキテクチャにはAXDSLで記述したカーネルが必要となる場合がある。同社はカーネルと開発ツールの公開を約束し、AX8860のソフトウェア開発キットをオープン化する作業も進めているとしている。
同社は、起動時から利用できるモデルとブラウザーインターフェースをうたう。用途として、コーディングエージェント、文書処理、動画生成、ロボティクスを挙げる。PCIeカードはまずLinuxホストに対応し、Windows対応は需要次第となる。発表時点では、NPUのツールチェーンは10月末までに提供される予定だった。
価格と納期はキャンペーンに連動
Sipeedが想定するメモリー128 GBモデルの価格3,999ドルは、6,950ドルのDGX Sparkより約2,951ドル、率にして42%安い。大幅な値引きだが、半額には届かない。また、メモリー128 GBのAMD Ryzen AI Haloの約3,999.99ドルという価格に近い。
発売スケジュールは、当初の「2026年中に出荷」という見通しから変更された。予約受付は始まっているが、公式FAQによるとKickstarterは2026年末の予定だ。Sipeedはキャンペーン終了後3カ月以内の出荷を目指すとしている。
- 2026年10月13日:Axeraが上海でAX8860シリーズを発表し、SipeedがMaixStationを披露。
- 2026年10月末:SipeedはNPUツールチェーンの提供開始を予定。
- 2026年末:SipeedはMaixStationのKickstarterキャンペーンを計画。
- キャンペーン終了後3カ月以内:Sipeedが示す出荷目標。
Sipeedは最終的な小売価格、確定した納期、MaixStationの独立検証済み性能をまだ明らかにしていない。生産能力、サポート体制、512 GBのProモデルの価格と発売時期も未確定だ。キャンペーン期間中にはリモートアクセスとレビュー用製品を提供する予定で、購入を検討する人が主張を確かめる次の機会となる。
要点
- MaixStationはメモリー128 GB、密なFP4で256 TOPSとするAxera AX8860Pを搭載し、約3,999ドルを目指す。
- Sipeedはメモリー帯域幅を毎秒273 GB、一般的な消費電力を40ワット、筐体サイズを11×11×3 cmとしている。
- 公式ベンチマークページの絶対速度は以前の公表値より低く、モデルや処理段階によって結果に差がある。
- ソフトウェア対応はAxera独自のアクセラレーション・バックエンドに依存し、開発ツールや追加コードの公開を予定している。
- Kickstarterは2026年末の予定で、キャンペーン終了後3カ月以内の出荷を目指すとしている。
- NvidiaやAMDの製品との比較を左右するのは、独立テスト、最終価格、確定した納期となる。