組み立てラインの高速化でメモリー供給に注目
Nvidiaは人工知能(AI)コンピューティングプラットフォーム「Vera Rubin」の全面生産を開始した。最高経営責任者(CEO)のジェンスン・フアン氏によると、サーバーノードの組み立てにかかる時間は、前世代の「Grace Blackwell」の2時間から5分未満に短縮された。この変更によりサーバー製造の高速化が見込まれる一方、Samsung Electronics、SK hynix、Micronが供給する先端メモリーの需要も増加する。
目次
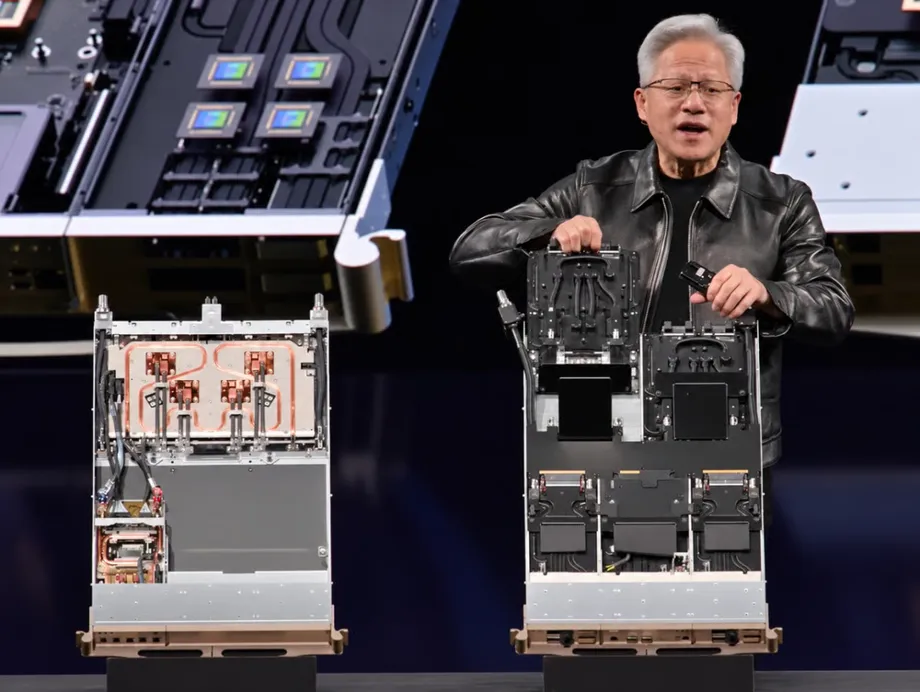
フアン氏はGTC Berlin 2026でVera Rubinのノードを披露し、ケーブルや配線がなく、100%液冷を採用した設計だと説明した。Grace Blackwellではシステムの80%に液冷を採用し、組み立て作業も大幅に多かった。
組み立て時間は120分から5分未満へと、95.8%超短縮される計算だ。大量のAIサーバーを構築する企業にとって、この工程の簡素化は工場での製造を速める可能性がある。ただし、チップの製造、メモリーのパッケージング、システム全体の組み立てに要する時間は、引き続き生産日程全体を左右する。
SamsungとSK hynixは、高帯域幅メモリー(HBM)の第6世代となるHBM4の需要獲得を競っている。MicronもVera Rubin向けの供給認定を受けており、主要HBMメーカー3社すべてが競争に加わる。
同時に、各社はHBM4の次世代製品となるHBM4Eもすでに披露している。各社の発表からは、つながり合う2つの課題が浮かぶ。Nvidiaは組み立てやすいサーバーを求め、メモリーメーカーは難度の高い製造工程を通じて、より高い速度と容量を実現しなければならない。サーバーの組み立てが速まるほど、チップを確実に納入することの価値も高まる。
Vera Rubinの内部で何が変わるのか
サーバーノードは、より大規模なコンピューティングシステムを構成する基本単位だ。Nvidiaは複数のノードを連携させ、多数のプロセッサーがモデルの学習や大勢のユーザーからの問い合わせへの応答など、負荷の高いAI処理を並行して行えるようにしている。
Vera Rubinは組み立てを簡素化する設計により、部品の接続作業を減らす。フアン氏がGrace Blackwellと比較した際に挙げたのは、ノードからケーブルや配線をなくしたことと、全面的な液冷への移行だった。
液冷は循環する液体を使って部品から熱を取り除く。高性能AIプロセッサーは大量の熱を発生させるため、温度を適切に管理することで、長時間にわたる負荷の高い処理でも安定した動作を維持できる。フアン氏が説明したVera Rubinでは、この方式をシステム全体に広げている。
Nvidiaの生産開始発表により、この設計は製造段階に入った。完成したシステムを顧客に届けるペースは、プロセッサー、メモリー、パッケージング、冷却装置の供給状況にも左右される。
AIの性能にHBM4が重要な理由
HBMは複数のメモリーチップを縦に積み重ね、AIプロセッサーの隣に配置する。シリコンを貫通する微細な接続部を通じて、各層の間でデータをやり取りする。積層メモリーとプロセッサーは共通の接続面で結ばれ、プロセッサーは情報に素早くアクセスできる。
AIプロセッサーの計算には、絶え間ないデータ供給が必要なため、このアクセス性能が重要になる。メモリーから十分な速度で情報が届かなければ、高性能プロセッサーでも待ち時間が発生する。帯域幅は1秒間に転送できるデータ量を、容量は一度に保持できるデータ量を示す。
HBM4はデータインターフェースを2,048ビットに広げ、前世代の2倍とした。Samsungによると、12層の積層品で帯域幅は毎秒2.8テラバイトに達する。Micronは、現在のHBM4製品で毎秒2.8テラバイトを超える帯域幅を実現したとしている。
速度と記憶容量の両方が重要だ。AIモデルの学習では、大量のデータを使った計算を繰り返す。推論と呼ばれる学習済みモデルの実行でも、モデル本体や処理中の問い合わせに関する情報を保持するメモリーが必要となる。
Samsungは速度、SK hynixは容量を追求
SamsungのHBM4は、第6世代の1c DRAM製造プロセスと、4ナノメートルのロジックプロセスで製造したベースダイを組み合わせる。ベースダイはメモリー積層部の下にある制御層だ。Samsungによると、ピン当たりのデータ転送速度は毎秒11.7ギガビットで、最適化した構成では毎秒13ギガビットに達する。
Samsung Electronicsのメモリー開発責任者、ファン・サンジュン氏は、同社が初の商用出荷を発表した際、製造プロセスの選択について次のように説明した。
実績のある既存設計を活用する従来の道を選ぶのではなく、Samsungは一歩踏み出し、1c DRAMや4nmロジックプロセスといった最先端ノードをHBM4に採用した
SK hynixは、公開したHBM4製品で異なるアプローチを取り、より確立された1b DRAMプロセスを使って16層を積み重ねた。この製品の容量は48ギガバイトで、Samsungの12層積層品の36ギガバイトを上回る。
SK hynixの積層品はSamsung製品より12ギガバイト多く、容量は3分の1大きい。この追加容量により、システムはより多くの作業用情報をプロセッサーの近くに保持できる。Samsungは新しい製造プロセスを使った高速転送に重点を置いている。
長い会話や複雑なAI処理では、とりわけ容量が重要になる。モデルは、キー・バリュー・キャッシュと呼ばれる一時領域に、問い合わせの前半部分に関する情報を保持する。より多くのユーザーが長い問い合わせを送ると、このキャッシュが利用可能なメモリーを使い切り、情報を低速なストレージに移さざるを得なくなる場合がある。
SK hynixの開発責任者、アン・ヒョン氏は、AIインフラに求められる性能規模は、2026年に比べて2030年には約20倍になる可能性があるとの見通しを示した。同氏が新たなメモリー技術の必要性を訴える根拠の一つは、推論システムがすぐにアクセスできる状態で保持すべき情報量の増加だ。
Micron、2027年分の生産能力はすでに契約済み
Micronは2026年10月中旬、台湾・台中市に2カ所目となる先端HBM組み立て・検査施設を開設した。AATT2と呼ばれるこの工場は、個々のメモリーチップを完成品の積層品に加工する能力を増強する。
Micronの社長兼最高執行責任者(COO)、マニッシュ・バティア氏は、開所式で需要について次のように述べた。
2027年に予定している生産能力は、すべてすでに契約済みだ
Micronの最高経営責任者(CEO)、サンジェイ・メロートラ氏は6月の決算説明会で、商用出荷開始から数カ月でHBM4の累計売上高が10億ドルを超えたと明らかにした。また、12層HBM4の生産拡大は、同等のHBM3Eでの生産立ち上げの2倍の速さで進んでいると述べた。
Nvidiaのフアン氏は6月、Samsung、SK hynix、Micronの3社すべてがHBM4の供給認定を受け、Vera Rubin向けの量産に入ったと確認した。顧客による供給認定とは、顧客のシステムで使用するために必要な検査を製品が通過したことを意味する。
Micronは2026年末までに、HBMの総生産能力を月間約10万枚のウエハーにすることを目指していた。6月時点で、台湾への累計投資額は1兆6,000億台湾ドルを超え、約502億ドルに相当する。
同社の苗栗県銅鑼工場では、2027年半ばまでに製品の全面出荷を始める計画だ。同工場のウエハーは、組み立てと検査のため約24キロ離れたAATT2に運ばれる見通しで、比較的近い距離にある2つの生産工程が結びつく。
パッケージングと人員が出荷の制約に
HBMの生産には、正常に動作するメモリーチップの製造だけでなく、多くの工程が必要だ。メーカーはシリコンを薄く加工し、精密な貫通接続を形成したうえで、複数の層を接合しなければならない。これらの工程で欠陥が生じると、使用可能な完成品の積層数が減る可能性がある。
積層数が増えるほど、成功させなければならない接続や接合の工程も増える。そのため、12層に新しい製造プロセスを採用するSamsungと、より確立されたプロセスで16層を実現するSK hynixは、製品仕様だけでなく製造上の課題も異なる。
装置メーカーのHanmi Semiconductorは、精密に制御した熱と圧力で層を接合する熱圧着ボンディング装置を提供している。SK hynixは6月、清州工場向けにアップグレード版のTC Bonder 4.5 Griffin装置を導入するため、4,420億ウォン、約3,300万ドル相当の契約を結んだ。Hanmiは次期機種のWide TC Bonderを2027年に商用投入する予定だ。
Micronは台湾での労使関係にも不透明感を抱えている。桃園の労働組合は、ストライキ参加資格を持つ組合員2,012人のうち1,994人が10月7日にストライキを承認したと発表した。対象者の約99%に当たる。台中の労働組合との調停は10月22日に予定されていた。台湾の頼清徳総統はAATT2の開所式に出席し、誠意ある交渉を求めた。
こうした動きにより、工場設備だけでなく人員配置にも注目が集まる。ストライキの承認は、労働争議を行うための手続き上の一段階であり、実際のストやそれに伴う納入の混乱は発表されていなかった。
HBM4Eの開発もすでに進む
SamsungとSK hynixは、2026年10月14日から16日までソウルのCOEXで開催されたSEDEX 2026で、次世代のHBM4E技術を披露した。両社はNvidiaのVera Rubin Superchipも展示し、メモリー競争とNvidiaのプラットフォームが密接に結びついていることを示した。
SamsungのHBM4Eは1c DRAMを採用し、4ナノメートルプロセスで製造したベースダイを使う。同社によると、ピン当たりの速度は毎秒最大16ギガビットで、帯域幅は毎秒3.6テラバイトに達する。
Samsungが公表したHBM4の帯域幅、毎秒2.8テラバイトと比べると、約29%の増加だ。12層構成のHBM4Eは48ギガバイトを搭載し、同じ層数のHBM4の36ギガバイトより3分の1多い。Samsungは8層・32ギガバイト版と、16層・64ギガバイト版も計画している。
SK hynixもピン当たり毎秒最大16ギガビットのHBM4Eを披露し、HBM4と比べてエネルギー効率が20%超向上すると説明した。Samsungは5月に、SK hynixは性能確認用のサンプルを6月に顧客へ提供した。Samsungは顧客の予定に沿った量産を目指している。
GPU脇のメモリーを超える構想
Samsungは、コンピューティングチップの脇ではなく、その上にメモリーを垂直に配置するアーキテクチャー「zHBM」の模型を展示した。両者の距離を縮めることで、データ転送にかかる時間と電力を削減できる可能性がある。
SK hynixは、高帯域幅フラッシュ(HBF)を披露した。同社は、既存のHBMの約10倍の容量を実現できると見込んでいる。この技術は、高速メモリーとストレージの間にもう一つの階層を加え、AIシステムがより大量のデータを扱えるようにする構想だ。
Samsungは、一部の計算をメモリー内部で実行できる製品も展示した。この方式は、別のプロセッサーへデータを転送する頻度の削減を目指す。いずれの構想も、関連する同じ課題に取り組んでいる。コンピューティングチップ自体が極めて高速でも、情報の移動には時間と電力がかかる。
zHBMとHBFはまだ構想・開発段階にあり、商用化の時期や顧客の採用は決まっていない。Vera Rubinの現行生産で当面の課題となるのは、HBM4の製造と納入だ。
注目すべき生産の節目
Nvidiaの全面生産への移行は、数カ月にわたるメモリーの供給認定、工場の拡張、将来製品の発表を経て実現した。主要な節目からは、プロセッサーとメモリーの生産日程が密接に結びつきつつあることが分かる。
- 2026年初頭:MicronのHBM4が量産に入る。
- 2026年5月、6月:SamsungとSK hynixがHBM4Eのサンプルを顧客に提供。
- 2026年6月:フアン氏が主要HBMメーカー3社すべての供給認定とVera Rubin向け生産を確認。
- 2026年10月7日:Micronの桃園労働組合がストライキを承認。
- 2026年10月14日~16日:SamsungとSK hynixがソウルのSEDEXでメモリー技術を披露。
- 2026年10月中旬:Micronが台中にAATT2のパッケージング・検査施設を開設。
- 2026年10月22日:Micronの台中労働組合との調停を予定。
- 2027年半ば:Micronが拡張した銅鑼工場からの製品全面出荷を目指す。
Vera Rubinのメモリー需要拡大はSamsungとSK hynixにとって追い風となる一方、Micronの生産能力がすでに契約済みであることから、供給をめぐる競争の激しさがうかがえる。顧客が必要とするのはシステム全体だ。したがって、ノードの迅速な組み立てには、十分なメモリー、信頼性の高いパッケージング、安定した工場運営が伴わなければならない。
要点
- Nvidiaによると、Vera Rubinは全面生産に入り、ノードの組み立て時間は2時間から5分未満に短縮された。
- 同プラットフォームは全面液冷を採用し、供給認定を受けたSamsung、SK hynix、MicronのHBM4を搭載する。
- Samsungの12層HBM4は36ギガバイト、SK hynixが披露した16層品は48ギガバイトの容量を持つ。
- Micronによると、台中の新しいHBM施設で2027年に予定している生産能力はすべて契約済みだ。
- 先端パッケージング、製造装置の供給、人員をめぐる交渉も、納入日程を左右する現実的な要因となる。
- SamsungとSK hynixはHBM4Eの検証を進めるとともに、AIメモリーの配置や構成の新たな方法を開発している。