RNAの塩基とその結びつきを学習するモデル
中国科学技術大学の研究者らは、RNA配列と計算機で構造を注釈したデータのペア約2100万組で学習させたオープンなRNA基盤モデル「structRFM」を公開した。配列と構造のペアデータ、モデルの重み、ソースコードが含まれ、他の研究機関も研究を再現し、システムを応用するための資料を利用できる。
目次
11月4日にNature誌で発表されたこの研究は、RNAの分子構成単位の並びと、分子の折りたたみを助ける結びつきの両方を学習するモデルについて説明している。Zfoldと呼ばれる三次元構造予測向けの応用モデルは、CASP15-natural、CASP16、RNA-Puzzlesの各評価でAlphaFold3に匹敵する性能を示したと著者らは述べている。
実用面での利点は、学習後のstructRFMにはRNA配列だけを入力すればよいことだ。分子構造の予測、RNAプロセシングに関わる部位の特定、機能によるRNA分子の分類など、さまざまな研究課題に使える情報を生成する。
Nature誌に掲載されたstructRFMの研究論文は、構造に関する知識をさまざまな予測課題に活用する方法として、この研究を紹介している。責任著者はPeng Xiong氏とS. Kevin Zhou氏で、筆頭著者はHeqin Zhu氏。
配列と同じく重要な折りたたみ
RNAはタンパク質の産生、遺伝子制御、遺伝情報の伝達を担う分子のプロセシングに関わる。RNAの配列とは、ヌクレオチドと呼ばれる分子単位の並びで、一般にA、U、C、Gの文字で表される。この並びには情報が含まれ、分子の折りたたまれ方はその働きを左右する。
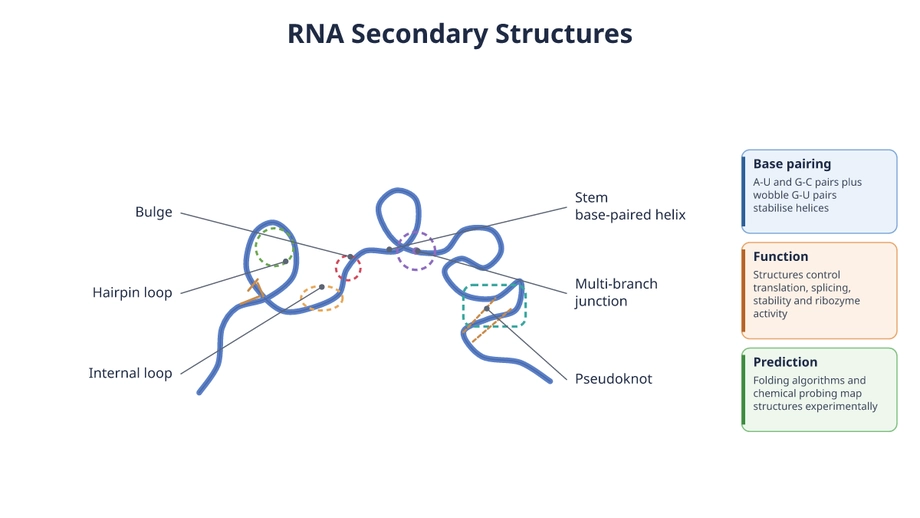
RNA鎖の一部は、同じ鎖の別の部分と対合することがある。こうした結びつきによって、対合領域、ステム、ループのパターンからなる二次構造が形成される。さらに分子は三次構造と呼ばれる三次元形状に折りたたまれ、それが活性や他の分子との相互作用に影響する。
多くのRNA言語モデルは、言語モデルが単語間の関係を学ぶのと同じように、大規模な配列データからパターンを学ぶ。structRFMは学習時に、どのヌクレオチド同士が対合するかという情報を加え、配列上で離れた位置の結びつきも学習できるようにしている。
研究チームは、幅広い目的に適応できる基盤モデルの柔軟性を保つことを目指した。構造予測だけに使えるシステムを作るのではなく、折りたたみに関する情報を、さまざまな用途に共通する基盤に組み込む狙いがあった。
学習ペア2100万組の構築
研究チームは、RNA配列と二次構造のペア約2100万組からなるデータセットを構築した。構造の注釈は計算機で生成したため、実験で構造を解明したデータだけからなるコレクションよりもはるかに大規模なデータで学習できた。
コンピューターによる予測には誤りが含まれる可能性があり、予測手法の長所と短所が反映されることもある。単一の予測器への依存を減らすため、研究者らは複数の情報源を統合する二次構造予測手法「MUSES」を導入した。アンサンブルとは、単一の情報源だけに頼らず、複数の予測情報を組み合わせる手法だ。
MUSESは、予測構造を使ったモデル学習における中心的な課題に対処する。学習用の注釈に誤りが繰り返し含まれると、モデルが学ぶ内容に影響する可能性がある。構造予測を組み合わせることで、塩基対に関する有用な情報を保ちながら、予測器の偏りを減らすことを目指した。
研究の学習・評価用リソースは、RNAcentral、Rfam、Protein Data Bankなど、広く利用されている生物学データベースを基にしている。データに関する記述では、RNAcentralのバージョン24.0、Rfamのバージョン14.10と15.0など、実験で使ったデータセットを追跡できるよう、該当するリリースが示されている。
隠した情報を使った学習
structRFMは、入力の一部を隠し、周囲の文脈から欠けた情報を復元するようモデルに学習させる「マスク言語モデリング」を採用している。RNAの場合、単語ではなくヌクレオチド間の関係を学ぶことになる。
研究チームは、ペアマッチング処理によって塩基対の情報を学習に取り入れた。動的なマスキング率を用い、構造上の結びつきを手がかりとする学習と、個々のヌクレオチド位置を隠す学習のバランスを取っている。これにより、局所的な配列パターンと折りたたみに関わる関係の両方を学ぶ機会をモデルに与える。
このモデルは、配列全体に関する情報、各ヌクレオチドに関する情報、ヌクレオチドのペアに関する情報という3種類の特徴量を生成する。特徴量とは、別の予測システムが利用できる数値表現のことだ。課題に応じて、その表現の異なるレベルを活用できる。
研究者らは、モデルの一部を除去または変更し、その寄与を調べるアブレーション実験も行った。この実験は、報告された性能向上に構造情報とマスキング戦略の両方が寄与したことを裏付け、structRFMの設計上の選択を支持する結果となった。
構造予測の評価結果
structRFMは、ゼロショット相同性分類で高い性能を示した。相同性とは、共通の進化的起源から受け継がれた関係を指す。この評価では、対象となる分類課題に特化した学習を行わずに、学習済み表現がそうした関係の認識にどれだけ役立つかを調べる。
著者らは、二次構造予測の精度向上と、新たに公開されたRNAファミリーに対する高い性能も報告している。RNAファミリーとは、配列や構造の特徴を共有する関連分子のグループだ。新たに公開されたファミリーを使うことで、既存のデータセットに含まれる既知のグループを超えて、モデルがどれだけ機能するかを検証できる。
三次構造予測に向けて、研究チームはstructRFMが学習した特徴量を応用し、三次元形状を予測するモデルZfoldを開発した。予測形状と、その予測から導き出した二次構造の両方で性能が向上したと著者らは報告している。
Zfoldは、分子構造予測の評価に使われるベンチマーク集、CASP15-natural、CASP16、RNA-Puzzlesで評価された。論文によると、これらの評価全体で、Zfoldの性能はAlphaFold3に匹敵する。比較対象はこれらのベンチマークでのZfoldの結果であり、基盤となるRNA表現を提供するのはstructRFMだ。
この研究が示す成果は、あらゆる用途を網羅する単一の精度スコアではなく、複数の種類にわたる。関連配列の認識、塩基対の予測、三次元形状の再構築はそれぞれ異なる課題であり、個別に評価する必要がある。
RNAプロセシングから機能分類まで
structRFMは、RNAの働きに関する課題でも検証された。対象にはスプライス部位の予測、内部リボソーム進入部位の特定、非コードRNAの分類が含まれ、評価範囲は分子形状にとどまらない。
スプライス部位は、細胞がRNAメッセージを処理する際に使う境界を示す。スプライシングでは、選択された部分が取り除かれ、残った部分がつなぎ合わされる。こうした境界を予測することで、遺伝情報のメッセージがタンパク質の産生に使われる前に、どのように組み立てられるかを研究者が調べやすくなる。
内部リボソーム進入部位(IRES)は、タンパク質を作る細胞機構が、RNAの内部から翻訳を開始できるようにする領域だ。その特定には配列中の機能的なパターンを認識する必要があるため、事前学習で獲得した情報を試す別の課題となる。
非コードRNAは、タンパク質産生の鋳型となる以外の役割を担う。分類とは、分子を関連するグループに振り分けることだ。著者らはこうした機能的な課題全体で性能が向上したと報告しており、予測対象が構造から生物学的な役割に変わっても、学習された表現が有用であることを示している。
研究チームは、配列を分割する手法を使って、長鎖非コードRNAの分類にもモデルを拡張した。長い配列を区切ることで、単一のまとまりとしては処理が難しい入力にもモデルを適用できる。
研究者に提供されるオープンリリース
公開されたリソースは、用途の異なる3種類からなる。データセットは学習に使った例を提供する。モデルの重みには学習中に得られた数値が含まれる。ソースコードには、ソフトウエアの実装と実行方法が記されている。
重みにアクセスできれば、研究者は事前学習をすべて繰り返すことなく、学習済みモデルを利用できる。データとコードを使えば、学習手順を詳しく調べ、実験を再現し、別の手法を開発できる。
論文では、GitHub上のプロジェクトリポジトリとして「heqin-zhu/structRFM」を挙げている。また、事前学習用データセットのZenodoアーカイブ(DOI 10.5281/zenodo.18272040)と、ソースコードおよびモデルチェックポイントのアーカイブ(DOI 10.5281/zenodo.18274292)も掲載している。DOIは、研究リソースを長期にわたって追跡できるようにする永続的な識別子だ。
データに関する記述によると、学習・テスト用データセットはプロジェクトリポジトリを通じて一般公開されている。研究で使われたIRESの処理済みデータ分割と、図の基となったデータも提供している。著者らは、データの利用に制限はないとしている。
こうした情報は比較検証に重要だ。研究者は使用されたデータセットと分割方法を確認し、評価を再実行し、別の学習条件が結果を変えるかどうかを検証できる。そのため公開は、モデルの再利用だけでなく、研究結果の精査にも役立つ。
研究チームと発表の日程
研究は、中国科学技術大学(USTC)の生物医学工学部と、MIRACLEとして知られる医用画像・ロボット工学・分析計算・学習研究室を中心に進められた。著者らの所属先には、合肥とUSTC蘇州高等研究院が含まれる。共著者のRuifeng Li氏は、杭州にある浙江大学のコンピューター科学技術学院に所属する。
教授のZhou氏と特別研究員のXiong氏が研究を構想し、統括した。Zhu氏は枠組みを設計・実装し、事前学習や複数の構造予測・RNA分類実験を行い、結果を分析した。他のチームメンバーは、相同性の検証、データセットの比較、IRESの特定、構造評価を担当した。
研究論文の発表と一般への紹介は、暦上の2日にまたがる。
- 2026年11月4日:Nature誌が「An open structure-guided RNA foundation model for generalizable prediction」の掲載を発表。
- 2026年11月5日:中国で研究成果とオープン公開が紹介され、オンライン版は早朝に公開されたと報じられた。
著者らは、中国国家自然科学基金、国家重点研究開発計画、江蘇省と蘇州市の研究プログラム、深圳市の三名医療プロジェクトから支援を受けたと報告している。競合する利益はないとしている。
RNA研究にもたらす変化
structRFMは、複数の研究活動に共通の出発点をもたらす。RNAプロセシングを調べる研究室は、別の研究グループが折りたたみの研究や非コード分子の分類に使うモデルと同じ基盤を応用できる。それぞれの用途には、引き続き個別の課題に応じた開発と評価が必要となる。
学習ペア2100万組、構造情報を用いた学習、公開されたチェックポイントの組み合わせにより、研究者はアルゴリズムの説明だけでなく、検証可能な具体的なシステムを手にできる。MUSESやマスキング実験から得られる設計上の選択肢も、他の研究チームが検証・変更できる。
報告された知見は、計算機による予測と分類が中心だ。医療応用に向けては、予測構造の確認や、特定のRNA分子に割り当てられた機能の検証など、さらなる生物学的実験が必要となる。
論文は、臨床応用の時期を示していない。直ちに変わるのは利用環境だ。世界中の研究者が学習リソースを入手し、実装を調べ、報告された性能向上が自らのRNAデータセットでも得られるか検証できる。
要点
- 中国科学技術大学の研究者らが、配列と二次構造のペア約2100万組で学習したRNA基盤モデル「structRFM」を公開した。
- モデルは配列パターンと塩基対の関係を学習し、配列だけを入力として特徴量を生成する。
- MUSESは複数の構造予測情報源を組み合わせ、動的マスキングは学習時に構造情報とヌクレオチド情報のバランスを取る。
- 著者らは、相同性分類で高い性能を示し、二次構造予測も向上したと報告。新たに公開されたRNAファミリーでも検証した。
- 三次構造予測向けの応用モデルZfoldは、名称が挙げられた3つのベンチマーク集で、AlphaFold3に匹敵する性能を示したと評価された。
- データセット、モデルの重み、ソースコード、評価用リソースは、再利用や再現実験に向けて一般公開されている。