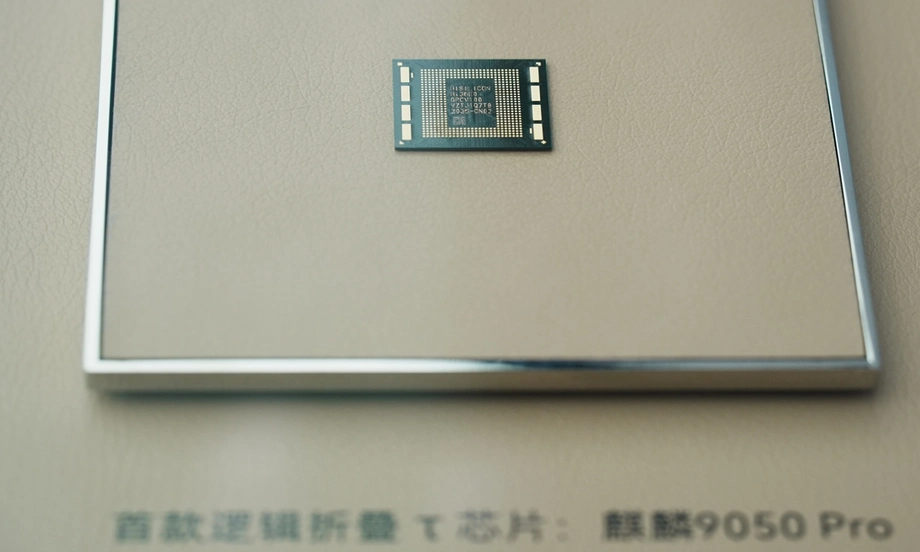
ファーウェイ、三次元チップ戦略をスマートフォンに導入
ファーウェイによると、Kirin 9050シリーズで「LogicFolding」の量産を開始した。演算回路を接続された層に配置することで、トランジスタ密度を53.5%高めたという。同社は2026年10月13日、上海の聯秋湖研究センターで開いた説明会で、チップ内部を電気信号が移動する距離を短くして性能を高める手法を明らかにした。
目次
ファーウェイは、複数のコアが連携して動作する場合、CPU性能が23%、グラフィックス描画性能が40%、人工知能(AI)の演算能力が前世代比で140%向上したと報告した。上位モデルのKirin 9050 Proは、1平方ミリメートル当たり2億3,800万個のトランジスタを搭載するという。
ファーウェイの半導体事業で無線端末チップの製品管理を統括する徐松宇氏は、同シリーズには5,000万を超えるハイブリッド接合点と、500万を超える有効な信号相互接続があると述べた。これらの接続により、異なる層の回路は、平面上の長い経路に頼ることなく、短い垂直経路を通じて通信できる。
この開発が重要なのは、規制により、ファーウェイが世界最先端の半導体製造装置の一部を利用できなくなっているためだ。同社は製造技術の制約に直面しながら、回路配置や接続、協調設計を通じて性能向上を目指している。
同社はMate 90 Pro Maxを試験端末、Mate 80 Pro Maxを比較対象端末に指定した。ファーウェイの数値は自社測定に基づくもので、バッテリー持続時間、長時間のゲーム性能、日常的なアプリでのAI応答性を把握するには、独立した検証が必要だ。
LogicFoldingで信号の経路を短縮
トランジスタは、ごく小さな電子スイッチだ。数十億個のスイッチが回路を構成し、ソフトウェアの実行やグラフィックスの描画、データ処理を担う。処理速度は、信号がスイッチ間をどれだけ速く移動できるかにも左右される。
従来の微細化では、素子を小さくして一定面積により多くのトランジスタを詰め込む。これに対しLogicFoldingは、回路を複数のシリコン層に配置し、高密度の垂直接続で結ぶ。これまで長い水平距離を横断していた接続も、層間の短い経路にできる。
ファーウェイによると、この設計では回路配置を1つのアクティブ層から2つに拡張する。同社の測定では、コアの配線長が20%短縮され、重要なタイミング経路は最大70%短くなった。クリティカルパスと呼ばれるこれらの経路で遅延が生じると、回路の処理速度が制限される。
徐氏は、複数のベアシリコン片、つまりダイを一体のプロセッサとして設計したチップだと説明した。回路の配置と接続を最初から三次元で計画し、各層が効率的に処理を分担できるようにしている。
配線が短くなれば、抵抗や不要な電気的負荷を抑えられ、信号をより速く、少ないエネルギーで伝えられる。一方、積層によって発熱が狭い範囲に集中するため、放熱が重要な工学的課題となる。
性能向上を示す数値の意味
ファーウェイが報告した性能向上は、プロセッサの異なる3つの部分に関するものだ。CPUは汎用演算、GPUはグラフィックス描画、NPUはAI計算を担う。CPU性能の23%向上は前世代の1.23倍、NPUの演算能力の140%向上は2.4倍に相当する。
同社は消費電力も大幅に削減したと報告している。同等の性能で比較した場合、NPUの消費電力は66%、GPUは58%、CPUコアは41%低いという。ファーウェイは10月の説明会で、Kirin 9050 Proの大型CPUコアのエネルギー効率が41%向上したとも説明した。
エネルギー効率は一定のエネルギーでどれだけ処理できるかを示す一方、消費電力はエネルギーを使う速さを示す。それぞれ異なる試験条件が必要だ。ファーウェイは、発熱を抑えるために動作電圧とクロック周波数も下げたとしている。
公表されたKirin 9050 Proの仕様には、9コアCPU、3.1GHzで動作するプライマリーコア、Maleoon 920 GPU、Da Vinci NPUが含まれる。スマートフォンの利用者にとって実際の価値は、長時間のゲームや負荷の大きいアプリ、AIへの連続したリクエストで、これらの部品がどのように連携するかに左右される。
数千万の接合点で層を接続
ハイブリッド接合は、極小の電気接点を介してシリコン表面同士をつなぐ技術だ。ファーウェイによると、Kirin 9050 Proの接合ピッチは1.5マイクロメートルで、隣り合う接続点の間隔は約0.0015ミリメートルとなる。
接続数の説明には注意が必要だ。ファーウェイの詳細な内訳では、接合点が5,000万超、有効な信号接続が500万超となっている。一方、10月の説明会での別の説明では、5,000万を超える接続を高速インターコネクトチャネルと呼んでいる。公表されたパッケージの内訳では、信号を伝える接続は全体の約10~15%とされており、物理的な接続の総数と、信号に使われる接続を区別する必要がある。
こうした接続の製造には、極めて高精度な位置合わせやウェハーの薄化、表面の平滑化が求められる。小さな隙間や銅接点のずれでも接続に支障が出る可能性がある。製造されたチップのうち正常に動作する割合を示す歩留まりは、複数のアクティブ層を連携させる場合、特に重要になる。
ファーウェイは、Kirin 9050 Proの製造委託先、製造プロセス、歩留まり、ベンチマークの詳細な条件を公表していない。こうした情報は、製造コストや公表された性能向上の再現性を評価するうえで参考になる。
AIモデルのメモリー使用量を削減
ファーウェイによると、Kirin 9050シリーズは、追加メモリー2.5GBでパラメーター数300億のAIモデルを実行できる。パラメーターとは、学習を通じて獲得され、モデルが回答を生成する際に使われる数値だ。
このモデルには、Mixture of Experts(MoE)と呼ばれる設計が採用されている。処理をモデル内の専門化された部分に分け、タスクに応じて一部を選択して動作させる方式だ。モデル全体を動かす場合と比べ、応答ごとの演算量を抑えられる可能性がある。
ファーウェイは、モデルの読み込み性能が25%向上し、メモリー使用量が前世代比で75%減ったと報告している。この比較では、新世代に必要なメモリーは従来の4分の1となる。同社は2.5GBを追加で必要となるメモリー量として説明しており、端末全体で必要なメモリー量ではない。
スマートフォン上でAIモデルを動かせば、対応する処理をリモートサーバーにリクエストを送らずに端末内で実行できる。利用者にとっては、演算能力だけでなく、読み込み時間とメモリー使用量も重要だ。モデルがOSや他のアプリと並行して動作でき、実用的な速さで応答する必要がある。
5月の発表から10月の詳細公表へ
ファーウェイは2026年5月25日、2026年IEEE国際回路・システム会議で、LogicFoldingの基礎となる構想を発表した。半導体事業の何庭波総裁が、同社の呼ぶ「Tau Scaling Law」を紹介した。
同社のTau Scaling Lawの発表では、半導体開発の指針として時間スケーリングが提案された。ギリシャ文字のタウは時定数を表し、電気回路がどれだけ速く応答するかに関係する指標だ。ファーウェイの手法は、個々の素子からコンピューティングシステム全体まで、遅延の削減を目指す。
導入は複数の段階を経て進んだ。
- 2026年5月25日:ファーウェイがTau Scaling Lawを発表し、秋に登場するKirinチップにLogicFoldingを初採用すると明らかにした。
- 2026年9月12日:Kirin 9050 Proを搭載すると報じられたMate XT 2 Ultimate Designが中国で発売された。
- 2026年10月1日:ファーウェイがKirin 9050 Pro搭載のMate 90 Pro Max Collector's Editionを発売した。
- 2026年10月13日:ファーウェイが上海でアーキテクチャーの詳細を公表し、2027年向けKirinチップの試験をすでに進めていると明らかにした。
ファーウェイによると、Tauの枠組みのもと、6年間で381種類のチップを設計・量産した。徐氏は、LogicFolding自体の研究は4年前に始まったと述べた。この枠組みは複数の最適化手法を含み、LogicFoldingは現在Kirin製品に採用され始めた特定の回路アーキテクチャーを指す。
製造装置の制約に対処する手法とコスト
ファーウェイは、オランダのASMLが製造する先端の極端紫外線(EUV)露光装置を利用できないという規制のもとで開発を進めている。これらの装置は、製造各社が微細な回路パターンを形成するのに役立つ。TSMCは2ナノメートルプロセスを用いたチップの量産を開始している一方、ファーウェイは製造と設計の異なる組み合わせで性能向上を目指す。
カウンターポイント・リサーチのリサーチ担当副社長ニール・シャー氏は、発熱、パッケージング、歩留まりを、ファーウェイの手法が直面する主な課題として挙げた。
「しかし、この並行する半導体開発の道筋は、まだ大規模生産で実証されていない。この手法は厳しい熱制約やパッケージングの複雑さを招き、製造歩留まりに影響する可能性がある」とシャー氏は述べた。
ファーウェイの財務数値からは、投資の規模がうかがえる。2026年上半期の研究開発費は1,213億8,000万元で、前年同期比25.2%増となり、売上高の25.9%に相当した。同期間の純利益は36%減の238億1,000万元だった。
消費者向け製品への投入は高価格帯から始まった。画面を3つ折りにできるスマートフォンMate XT 2は、中国で1万9,999~2万4,999元で発売された。ファーウェイによると、Kirinチップを搭載する端末の出荷台数は、2023年8月の復活以降、1億台を超えており、今後のプロセッサー世代にとって大きな製品基盤となる。
ファーウェイが目指す2027年と2031年
ファーウェイは2027年に、ハイブリッド接合のピッチを1.5マイクロメートルから1マイクロメートルに縮小する計画だ。配置が同じであれば、縦横の間隔を縮めることで、理論上は単位面積当たりの接続位置を約2.25倍にできる。実際に利用できる密度は、配線や電力供給、製造要件によって変わる。
同社によると、2027年向けKirinの試験用シリコンには、すでに1億を超える垂直接続があり、試験結果は期待どおりだという。ファーウェイはさらに、3年以内に接合ピッチを720ナノメートルとする目標や、将来の設計で3層または4層のアクティブ層を採用する可能性を示している。
2031年について、ファーウェイが公式に掲げる目標は、14オングストローム(1.4ナノメートル)プロセス相当のトランジスタ密度だ。密度は一定面積に収まるトランジスタ数を示す。製造プロセスはトランジスタの動作や電力特性、生産要件も左右するため、ファーウェイの目標はチップ性能の一側面に関するものだ。
DGAグループでアジア・南北アメリカ地域のテクノロジー部門を率いるポール・トリオロ氏は、製造歩留まりや電力、発熱、デバイス性能に課題が残ると指摘している。徐氏も、設計ツール、製造ばらつきの補正、エネルギー制御、層間の相互接続、ベンチマーク手法を今後の課題として挙げた。
スマートフォンを超える野心
ファーウェイのTauの枠組みは、ソフトウェアやプロセッサーアーキテクチャー、大規模コンピューティングシステムにも及ぶ。チップレベルでは、命令やデータが効率よく移動するよう、ソフトウェアとシリコンを一体で設計すると説明している。システムレベルでは、UnifiedBusによって「SuperPoD」と呼ぶ大規模なコンピューティング機器群の通信遅延を減らすことを目指す。
バルセロナ・スーパーコンピューティング・センターの所長、マテオ・バレロ氏は、成功にはアプリケーションやソフトウェア、プロセッサーアーキテクチャー、メモリー、トランジスタの連携が欠かせないと述べた。
「トランジスタは重要だが、いま大切なのはシステム全体がどう動作するかだ」とバレロ氏は述べた。
これはスマートフォンの発売より大きな課題となる。データセンターは、多数のプロセッサーにデータを供給しながら、通信や電力消費、冷却を管理しなければならない。ファーウェイはLogicFoldingを法人向けコンピューティングに広げ、2030年までにAscend 990 AIチップを発売する計画を示している。
ファーウェイが国内のAIコンピューティング分野で進展すれば、中国でのエヌビディアの商機にも影響する。アジア・グループでデジタル部門の共同責任者を務めるジョージ・チェン氏は、現地の代替製品が開発されるなか、H200のような先端チップを中国で販売するエヌビディアの機会は狭まりつつあると述べた。
現時点でのファーウェイの具体的な成果は、密接に接続されたアクティブ層を中心に設計したプロセッサーを、商用製品に投入したという報告だ。次の節目は2027年世代のKirinチップ、接合密度の向上、そして長時間の負荷や大規模生産で同アーキテクチャーがどのような性能を示すかだ。
要点
- ファーウェイによると、Kirin 9050チップでLogicFoldingの量産を開始し、トランジスタ密度を53.5%高めた。
- 公表された性能向上は、CPUが23%、グラフィックスが40%、NPUの演算能力が140%。
- この設計では2つのアクティブ層を使い、接合点の間隔は1.5マイクロメートル。
- ファーウェイによると、2027年向けKirinチップは試験中で、接合ピッチを1マイクロメートルに縮小する計画だ。
- 同社が掲げる2031年の目標は、1.4ナノメートルプロセス相当のトランジスタ密度。
- 発熱や製造歩留まり、設計ツール、生産コストが引き続き重要な工学的課題となる。