仮想住宅で訓練されたロボット、実際の部屋に挑む
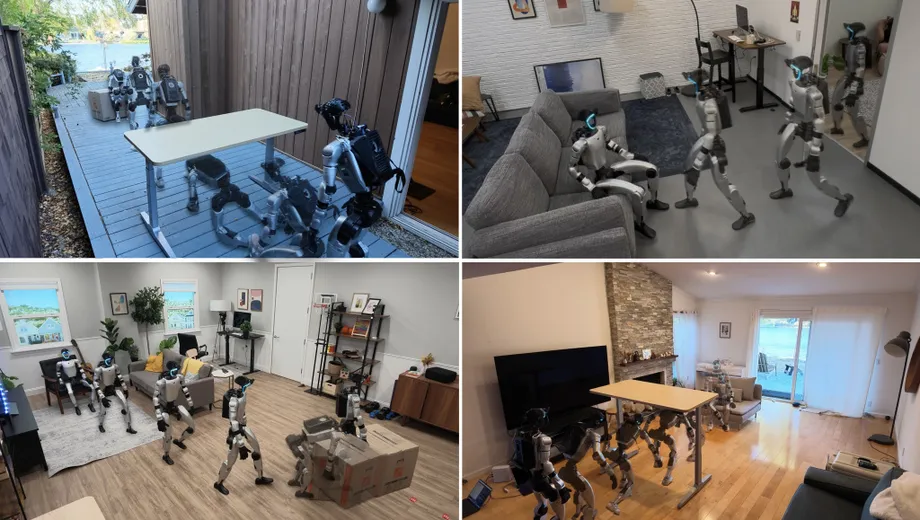
Appleの研究者によると、ヒューマノイドロボット制御システム「HALO」は、事前にスキャンもマッピングもしていない6カ所の実環境で、360回の試行を通じ、個別の物理タスクで平均91%の成功率を達成した。Unitree RoboticsのG1で稼働するこのシステムは、シミュレーションで得た知見を生かし、見慣れない空間を移動し、家具に座り、狭い開口部を通り抜け、箱を押した。
目次
この成果は、2026年11月4日にarXivへ投稿された論文「Perceptive Humanoid Motion from Simulation」で報告された。Appleチームの論文によると、コンピューターで生成した1,000種類の住宅環境で約300時間分の合成データを用いて訓練した後、システムを実機ロボットに直接移行させた。
より長いタスクは難度が高かった。別の実環境で、HALOは3種類の動作の組み合わせをそれぞれ10回試し、平均成功率は70%だった。障害物の下をかがんで通り、目標物に近づいて箱を押す動作の連続は、10回中5回成功した。
実用面での進歩は、指示の理解と、見慣れない家具のある場所で全身を動かすことを結び付けた点にある。椅子に座るという指示には、座面を見つけ、経路を確保し、体の位置を調整したうえで、バランスを保ちながら腰を下ろす必要がある。HALOは、こうした役割を連携する3つの制御層に分担させている。
著者は、Apple所属と記載されたSiyuan Hu、Abulikemu Abuduweili、Yue Meng、Shipeng Liu、Quentin Leboutet、Chen Chen、Matthias Müller、Vladlen Koltunの各氏。データ生成、訓練、タスク計画、動作生成、シミュレーションおよび実機ロボットでの動作追跡を含むコードも公開した。
成功率91%が示すもの
6つの個別スキルの成功率には差があった。最も成績が良かったのはかがむ動作で、試験した動作のうち座る動作が最も低かった。
- 指定された物体まで移動:92%。
- 家具に座る:85%。
- 半開きのドアを通り抜ける:93%。
- 障害物の下をかがんで通る:100%。
- 障害物の下をはって通る:90%。
- 箱を押す:88%。
かがむ動作と座る動作の差は15ポイントだった。座るには、適切な場所に到達するだけでは足りない。ロボットは家具に体を合わせ、座面へ体重を移す必要がある。そのため、視覚による理解と物理的な制御の両方が求められる。
評価に使われた6つの環境は、いずれもHALOにとって未知の場所だった。研究者は事前にスキャンしておらず、訓練にも使っていない。論文ではこれをゼロショット転移と呼ぶ。つまり、目的地ごとの追加訓練をせず、シミュレーションでの訓練から実環境へシステムを移行させた。
公開された実演映像では、G1が人の後を追う、ソファに座る、半開きのドアを横向きに通り抜ける、テーブルの下をかがんだり、はったりして通る様子も確認できる。目的地に向かって歩くだけでなく、周囲の空間に応じて姿勢を調整する仕組みが示されている。
長い指示が難しい理由
HALOが試した3種類のタスクの組み合わせでは、結果に幅が出た。ドアを通り抜けてから目標物へ向かう動作は、10回すべて成功した。かがんでから座る動作は6回、かがんで目標物に近づき箱を押す動作は5回成功した。
全体では30回の試行のうち21回成功し、成功率は70%となる。個別タスクの平均より21ポイント低い。ただし、連続動作の試験は異なる環境で、試行数も少なかった。
動作を連続させると、ある動作の結果が次の動作の開始位置となるため、問題が起きる機会も増える。例えば障害物の下を通り抜けた後、ロボットが目標物に近づき、次の動作に移れる位置にいる必要がある。
HALOは視覚による確認でこれに対応する。計画システムはロボット視点の映像を見て、現在の動作が成功したかを判断し、次に進むか、やり直すかを決める。結果からは、有用なスキルをつなげることが、個別に実行するより難しい課題だと分かる。
3つの層で指示を動作に変換
最上位の制御層はタスク計画を担う。画像と言葉の両方を処理するAIの一種である視覚言語モデルを使い、指示とカメラ映像をもとに状況を解釈する。標準モデルはQwen3.6-35B-A3Bで、ロボットが搭載するMac mini上でローカルに動作する。
計画システムは2秒ごとに起動する。座席を指定せずに座るよう求められた場合は、視界にある物体から適切なものを選ぶ。テーブルが椅子への経路をふさいでいれば、障害物の下をかがんで通り、椅子に近づいて座るという小さな動作に分けることができる。
中間層は、それぞれの小タスクを動作計画に変換する。訓練中にエンコーダーのパラメーターを固定したQwen3.5-2Bと、全身の動作を生成する拡散トランスフォーマーデコーダーを組み合わせている。エンコーダーが画像と指示を動作モデルで利用できる表現に変換し、デコーダーが計画した姿勢を出力する。
この層はおよそ5秒先まで見通し、毎秒約3回、計画を立て直す。そのため、周囲を確認せずに5秒間の動作を一度に決めるのではなく、新たなカメラ映像をもとに動作の計画を更新し続ける。
モーショントラッカーと呼ばれる最下層は、その計画を毎秒50回、関節への指令に変換する。深度画像とロボット自身の位置や動きの情報を組み合わせ、バランス、接触、モーターの制限を考慮しながら計画どおりに動けるようにする。
G1の背中に搭載されたMac mini
実機の構成では、M4 Proチップとユニファイドメモリー64GBを搭載したMac miniを保護ケースに入れ、G1の背中に取り付けている。このコンピューターが、より負荷の高いタスク計画と動作生成のモデルを実行する。G1内蔵のプロセッサーはモーショントラッカーを動かす。
専用のヘッドマウントにはOAK-1Wカメラを搭載する。カラー映像は解像度1280×800ピクセル、毎秒30フレームで、視野角は120度。広い視野により、ロボットが動く間、近くの家具や開口部を捉えやすくなる。
ロボットはケーブルにつながずに動作し、各ソフトウェアはメッセージングシステムのZeroMQを通じて通信する。標準のローカル構成では、インターネット接続なしで動作できる。設定すれば、HALOはAPIを介してクラウドモデルを呼び出すこともできる。
計算処理の分担は、制御階層に対応している。指示の理解は比較的少ない頻度で行える一方、動いているロボットの安定性を保つには、はるかに頻繁な更新が必要になる。モーショントラッカーが現在の計画を実行する間に、動作生成モデルが新たな計画を算出するため、モデルの計算のたびに停止する必要がない。
1,000軒の仮想住宅で訓練データを生成
HALOの訓練パイプラインは、特定のデータ不足に対処する。ヒューマノイドが何を見て、どんな指示を受け、全身をどう動かすべきかを結び付けるデータだ。一般的な動画には動作の映像が含まれるが、このシステムの訓練には、映像と指示、詳細なロボットの動作を組み合わせる必要がある。
著者らは、人が操作したり、装着型の記録装置を使ったりして実演データを集める方法について、必要な時間を次のように説明している。
人がすべてのエピソードを手作業で実演しなければならないため、データを1時間分集めるには、少なくとも人の作業時間が1時間必要になる。
これに対しHALOは、シミュレーション内で対応するデータを作る。まず、タスクを動作の区間に分ける。例えばアームチェアに座る動作は、前進し、向きを変え、座面に腰を下ろす動作から成る。テキストによる指示、経路上の目印、重要な姿勢をもとに、「Kimodo」と呼ばれる動作生成モデルが動きを作る。
続いて自動の幾何学的チェックを行い、足の滑り、床をすり抜ける体、急な跳躍、関節の可動範囲を超える動きなどの問題について、候補となる動作を評価する。パイプラインは最も優れた候補を選び、仮想の部屋に配置する。
手続き型シーン生成ツールのInfinigenが、リビング、オフィス、寝室など、間取りや家具が異なる1,000種類の環境を用意する。システムは、ロボットの計画した動作と目標物が周囲の家具に衝突しない配置を探す。
次にシミュレーターが、物理環境に合わせた魚眼カメラを使い、動作中にロボットが見る映像を描画する。照明、露出、色、コントラスト、ぼかし、センサーのノイズを変えて映像に多様性を持たせる。こうして、指示、カメラ映像、それに対応する身体の動きを結び付けたデータが作られる。
計算コストと人の作業
主要な訓練データセットの生成には、Nvidia H100グラフィックスプロセッサー250基を使い、約48時間かかった。一般にGPUと呼ばれるこれらのプロセッサーは、多数の計算を並行して処理し、大量のシミュレーションデータを一度に生成できる。
動作生成モデルは、Nvidia B200 GPU 64基を使った模倣学習で訓練した。模倣学習では、モデルが手本となる動作の再現を学ぶ。モーショントラッカーの訓練にはH100 GPUを4基使い、強化学習と方策蒸留を組み合わせた。
強化学習では、試行と、その性能に関するフィードバックを通じて制御器を訓練する。方策蒸留は、学習した動作を別のモデルに移す手法だ。HALOでは、こうした手法によって、計画した姿勢を実機ロボットが実行できる動きに変換する。
工程の一部は今も人が設計する。新たな実機タスクを追加するには、指示文を作成し、重要な姿勢を設計する必要がある。また、動作によっては人間の動画やモーションキャプチャーのデータを利用する。タスクの説明と制約を設定すれば、パイプラインはそれらを多様な仮想の部屋で再利用できる。
変わったのは、実演データを増やす方法だ。すべての動作を人が実演する代わりに、HALOは計算資源を使い、タスクの多様なパターンを生成して検証する。
視覚だけでは接触の問題が残る
研究者によると、HALOは現在、主に視覚に頼っており、接触を直接感知できない。物体がカメラの視界から外れたり、別の物に隠れたりするような、強い物理的接触を伴うタスクでは性能が低下することがある。
箱を押す動作は、その問題をよく示している。箱が動く間も、ロボットは箱に対して適切な位置を保つ必要がある。カメラは目に見える位置の情報を得られるが、視界が遮られても役立つ接触の情報は、触覚センサーから得られる可能性がある。
研究者らは今後の方向性の一つとして触覚センサーを挙げているが、導入時期は示していない。今回の結果は課題の境界を具体的に示す。HALOは見慣れない部屋で視覚に基づく複数のスキルを実行できる一方、長い動作の連続や接触を伴うやりとりの信頼性には、なお課題が残る。
この研究が変えるもの
Appleの研究は、データ生成、言語に基づく計画、物理的な制御を一つのシステムに統合し、初めて訪れる部屋でヒューマノイドを動かす。最も注目される成果は、1,000種類のシミュレーション環境での訓練を、試験場所6カ所の事前マッピングなしに360回の実機試行へ移行できたことだ。
公開されたコードにより、シミュレーションとハードウェアの両方でパイプラインを使った研究を進められる。訓練データを生成する仕組みに加え、動作を生成、追跡、連携させるモデルやソフトウェアも含まれる。
ロボットに座るよう頼んだり、箱を動かすよう指示したりしたとき、信頼性は一連の処理全体に左右される。適切な物体を見つけ、近づき、接触し、動作を完了しなければならない。個別タスクの結果は、HALOがこの一連の処理で進歩したことを示す。一方、動作を連続させた場合の結果からは、複数の動作を同じ安定性でつなげるには、なお改善が必要だと分かる。
要点
- Appleの研究者は、論文「Perceptive Humanoid Motion from Simulation」を2026年11月4日にarXivへ投稿した。
- HALOは、見慣れず、地図も作成されていない6カ所の実環境で、個別タスク360回の試行を通じて平均成功率91%を達成した。
- 別の実環境で試した3種類のタスクの組み合わせは、30回の試行で平均成功率70%だった。
- システムは、タスク計画、動作生成、毎秒50回の関節指令を出すトラッカーを組み合わせている。
- 訓練には、1,000種類の環境で生成した約300時間分の合成データを使った。
- Unitree G1に搭載されたMac miniにより、インターネット接続なしでローカル動作できる。
- 訓練では人によるタスク設計が今も必要で、接触を感知する能力の限界も課題として残る。