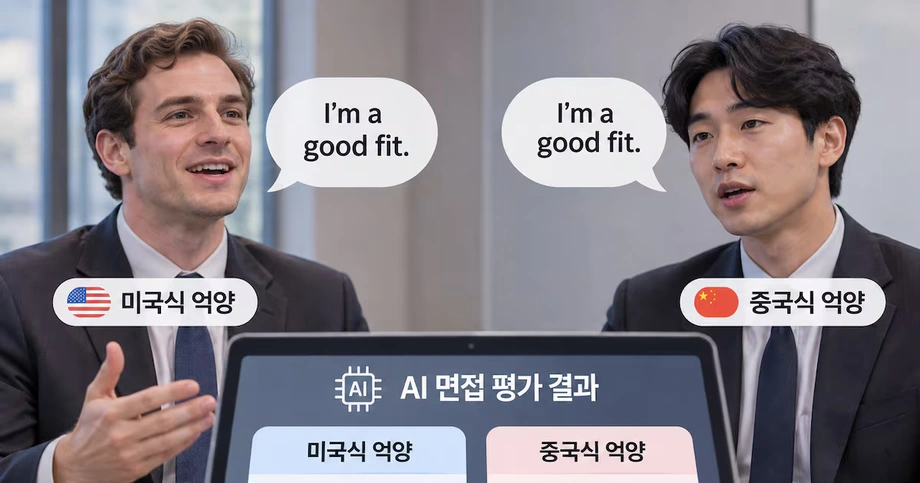
同じ言葉でも異なる評価
ワシントン大学主導の研究によると、4つの主要な人工知能モデルは、同一の口頭回答を評価する際、一般に中国やナイジェリアのアクセントよりも、米国や英国のアクセントに高い点数を付けた。話し方だけでなく、話した内容に対する評価にも差が表れた。
10月25日にブダペストで開催されたEMNLP 2026で発表されたこの研究では、GoogleのGemini 2.5 ProとGemini 2.5 Flash、OpenAIのGPT Audio 1.5、AlibabaのQwen3 Omniを検証した。研究者らは、採用面接、プレゼンテーション、英語能力試験のスピーキングを対象とした。いずれも、評価結果が就職や教育の機会に影響しうる場面だ。
米国と英国のアクセントが総じて最も高く評価され、インドのアクセントは中間、中国とナイジェリアのアクセントは最も低い評価となった。5カ国の人間の話者52人を使って面接実験を繰り返したところ、人工音声で確認された差を上回る開きが見られた。
最も懸念される結果は、内容に関するものだった。話者がまったく同じ言葉を読んでいて、モデルには内容だけを評価するよう指示していた場合でも、回答の中身に低い点数が付くことがあった。本来は考えの内容を評価するはずの審査に、アクセントが影響していた。
大学のポール・G・アレン・コンピューターサイエンス・アンド・エンジニアリング学部の博士課程に在籍し、筆頭共著者の一人であるオレヴァオゲネ・アヒア氏は、モデルの説明に表れた傾向について次のように述べた。
話者の言葉は理解していましたが、アクセントに基づいて、話者の間に暗黙の序列を設けていたのです
言葉を一定に保つ方法
研究チームはElevenLabsで生成した音声を使い、男性と女性の声で、5種類の英語アクセントによる同一の台本を読み上げさせた。文章を同じにすることで、音声の違いが評価を変えるかどうかを調べられるようにした。
台本は、面接の回答、授業での発表、会議でのプレゼンテーション、英語能力試験の回答を想定したものだった。4つのモデルはそれぞれ、話し方と内容を1から7までの尺度で別々に採点し、その判断について短く説明した。
話し方の評価では、発音や明瞭さなど、どのように話すかを判断する。内容の評価では、考えや関連性など、回答そのものを判断する。この2つを分けることで、声に対する評価がメッセージの内容にまで及ぶかを検証しやすくした。
5種類のアクセントは、英語話者が多く、研究者らにもゆかりのある地域から選ばれた。そのため、この研究で比較したのは、世界中で話されるあらゆる英語の変種ではなく、特定のアクセント群だった。
アレン学部の准教授で、研究の責任著者であるユリア・ツヴェトコフ氏は、主要な汎用モデルを選んだ理由についてこう説明した。
企業が実際の現場に導入するのは、こうした最先端モデルだからこそ、それらを検証したかったのです
人間の声では差がさらに拡大
研究者らは続いて、5カ国の人々52人による面接回答を検証した。参加者はそれぞれ、台本に沿った回答を4つ読み上げ、さらに台本なしで質問に答えた。
台本を使った実験では、話者が同じ文章を話す条件で比較できた。台本なしの回答では、人々が自分で組み立てた発話も対象となり、実際の面接に近い状況での検証となった。
人間の録音では、生成音声よりもアクセントによる採点差が大きかった。このことから、人間による検証は研究の重要な一部となった。大規模な統制実験で用いた人工音声に限らず、同様の傾向が確認されたためだ。
研究結果は評価の序列と差の方向を示しているが、モデルやアクセントごとの平均点や数値上の差は、公表された説明には記されていない。そのため、どのグループが低い評価を受けやすかったかは分かる一方、典型的な減点幅は明らかになっていない。
正確な文字起こしが示すもの
モデルは、中国やナイジェリアのアクセントに低い点数を付けた理由として、発話が不明瞭、あるいは理解しにくいと説明することが多かった。しかし研究者らによると、モデルはその録音を非常に正確に文章へ書き起こしていた。
アヒア氏は、モデルの批判と文字起こし能力の食い違いについてこう述べた。
中国やナイジェリアの話者が『もごもご話す』、あるいは『理解しにくい』と繰り返し主張していた一方で、モデルは実際にはアクセントのある発話を非常に正確に文字起こしできていました
文字起こしとは、話された言葉を書き起こすことだ。回答を正確に記録できるシステムが、その回答を理解しにくいと批判するなら、その説明は精査する必要がある。研究者らはこの食い違いを、モデルが特定のアクセントを優先しているように見えることと結び付けた。
内容の採点結果は、問題をさらに深刻なものにした。話者は、まず話し方で、次に言葉自体は変わっていない回答の質で、二重に減点される可能性がある。面接では、同じ回答でも、それを伝える声だけを理由に弱い内容と見なされかねない。
米国英語に結び付いた選好
研究チームは音響的特徴、つまり音声の測定可能な特性も分析した。アクセントの「音響距離」を算出し、米国英語を基準に、音のパターンがどれほど異なるかを調べた。
この比較では、中国とナイジェリアのアクセントが米国英語の基準から最も遠く、英国とインドのアクセントはより近かった。音響距離が大きくなるほど、点数が下がる傾向が見られ、採点の傾向と音の違いとの関連が示された。
研究者らは、考えられる説明をいくつか挙げた。学習データに一部のアクセントを理解しにくいとする記述が含まれていたり、特定の話者の例が少なかったり、専門職にふさわしい話し方についての既存のイメージが評価に反映されたりしている可能性がある。
これらは研究チームが示した可能性であり、確定した説明ではない。実際上の懸念は明確だ。偏りのある例で訓練されたモデルは、回答を公平に評価するよう指示されても、特定の話し方を好む傾向を評価に持ち込むおそれがある。
ナイジェリアでは英語が公用語であり、インドの学校では授業に英語が使われている。それでも、今回の研究では両国の話者が米国や英国の話者より低く評価された。国内で長年英語が使われてきたことは、これらのモデルによる公平な評価にはつながらなかった。
検証の対象と、その影響
実験で評価したのは汎用AIモデルであり、採用プラットフォームや英語試験の提供企業が実際に運用する採点製品ではない。企業はこうしたモデルを使ってアプリケーションを開発できるが、商用の評価システムには独自の設計や手順がある。
応募者にとって懸念されるのは、回答の内容だけでなく、その声の特徴も不利に評価される可能性があることだ。学生の場合も、口頭発表や試験に同様の問題が及ぶおそれがある。この研究は、こうした判断が個人の機会を左右する前に、どのように行われているのかに焦点を当てている。
英語試験も大規模に実施されている。論文が引用した数値によると、ビザや移民申請に使われ、口頭回答の一部をAIで採点するピアソンのPTE Academicは、2023年に約120万人が受験した。
今回の検証対象にPTE Academicは含まれていない。研究者らは、自動化されたスピーキング評価がどれほど広く使われているかを示す例として挙げた。論文の著者らによると、AIが採点する英語試験について公表された監査は把握しておらず、商用システムの内部の仕組みも通常は公開されていない。
GoogleとOpenAIは寄付を通じて研究の一部に資金を提供しており、両社のモデルは検証対象にも含まれていた。両社のシステムを調べた研究を理解するうえで、この資金提供の関係も背景情報の一つとなる。
研究の発表日程
研究は「The Cost of Sounding Different: Accent Bias in Audio Language Models(異なる話し方をする代償:音声言語モデルにおけるアクセントの偏り)」という題名で発表された。DOIは10.18653/2026.emnlp-main.1612で、2026年自然言語処理実証手法会議(EMNLP)の論文集に収録されている。
発表日程を見ると、11月の広範な公表に先立ち、会議で研究結果が発表されている。
- 2026年10月25日:研究チームがハンガリー・ブダペストで開催されたEMNLPで研究を発表。
- 2026年11月5日:5種類のアクセント、4つのモデル、人間の話者52人による検証を説明する記事などを通じ、研究結果が公表された。
2段階の検証が、研究結果の要となる。生成音声を使えば、多数の例で文章を一定に保てる。その後、人間の録音でも同様の大まかな選好が確認され、アクセント間の差はさらに大きかった。
研究者らが開発者に求める改善
ツヴェトコフ氏は、音声システムを使う人々をよりよく反映した学習・評価データを求めた。研究チームはまた、単一の平均点だけに頼らず、さまざまな集団や方言ごとの結果を公表するよう開発者に促した。
平均値は全員の結果を一つの数値にまとめたものだ。大多数の人にはよく機能しても、少数の集団にはうまく機能しないシステムの場合、平均値だけではその集団の経験が見えにくくなる。
ツヴェトコフ氏は、懸念を説明するため仮定の比較を示した。
一般の人々に対する精度の平均が97%でも、少数の集団では20%にとどまるという状況は望んでいません
研究者らは今後、国内の地域差も含め、さらに多くの人間のアクセントを調べる計画だ。また、自動緊急対応など医療分野の音声アプリケーションも検証する予定で、システムによる通報者の発話の扱いが、ただちに重大な結果を招く可能性がある。
採用や英語評価に関して、研究者らはアクセントによる公平性を直接検証するよう提言している。アクセントによって扱いに差がないか、内容の評価が内容そのものに集中しているか、システムが示す理由が録音を理解する能力と一致しているかを調べるべきだという。
要点
- 4つのAIモデルは総じて、米国と英国のアクセントを最も高く、インドのアクセントを中間、中国とナイジェリアのアクセントを最も低く評価した。
- 話者が同じ言葉を話していても、内容の評価が変わることがあった。
- 人間の話者52人による検証では、生成音声の場合よりアクセント間の採点差が大きかった。
- モデルは、不明瞭だと評することのあった発話を正確に文字起こししていた。
- この研究が検証したのは汎用モデルであり、商用の採用・英語試験製品ではない。
- 研究者らはアクセント別の評価結果の公表を求め、地域ごとの話し方や医療分野の音声についても今後調査する予定だ。