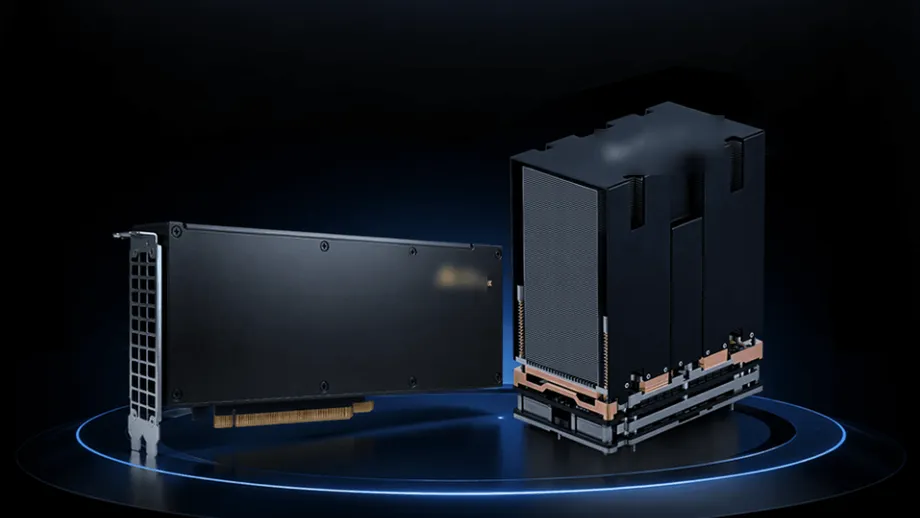
稼働するGPUとスループット5%向上の主張
Iluvatar CoreXは上海でTiangai 300グラフィックスプロセッサを公開実演し、第三者による推論テストで5%上回ったとする結果を示し、NvidiaのH200に対抗する中国製製品としてアピールした。2026年10月28日のメディア向け公開イベントでは、8基のGPUを搭載した学習システムも披露し、144基のGPUと18基のCPUを収めたラックについて説明した。
目次
比較の根拠となったのは、Iluvatar CoreXによると、上海電気集団が7月に実施したテストだ。大規模言語モデルの処理を2つの段階に分ける構成で、Tiangai 300は、結果をカード1基当たりの数値に換算した場合、エンドツーエンドのスループットでH200の1.05倍に相当する性能を達成した。
スループットとは、システムが一定時間内に処理する有用な作業量を指す。チャットボットの場合、毎秒生成できるテキストの量などがこれに当たる。基準性能の1.05倍という結果は、そのテスト条件下で出力が5%多かったことを意味する。
同社はTiangai 300について、測定テストでH200相当の性能に達した初の中国製汎用GPUだと説明した。10月の実演では比較対象を言語モデル、画像生成、動画生成に広げた一方、別の学習実演ではNvidiaのH100を基準とした。
イベントで披露されたのはチップの仕様だけではない。Iluvatar CoreXはカード、サーバー、高密度ラック設計、ソフトウェアツールに加え、異なる種類のプロセッサ間でAI処理を分担する方法も紹介した。同社の商業面での売り込みは、これらを組み合わせることで、待ち時間を減らし、より低コストで有用なAI出力を実現できるというものだ。
H200との比較で測定したもの
上海電気集団が7月に実施したテストでは、プリフィルとデコードを分離する方式(PD分離)が用いられた。プリフィルは、言語モデルがユーザーの依頼と関連資料を読み込む段階だ。デコードは、モデルがトークンを1つずつ生成して回答を作る段階を指す。トークンとは、AIシステムがテキストを分割した小さな単位だ。
この2段階を分けることで、読み込みと生成に異なるリソースを割り当てられる。そのためTiangai 300の結果は、特定の構成で運用した場合のもので、総合性能をカード1基当たりの換算値で示している。
Iluvatar CoreXは、第三者テストの主要結果について、詳細なテスト方法、モデルの一覧、負荷条件を公表していない。独立した再現検証には、これらの情報に加え、換算の計算方法やソフトウェア設定も必要となる。コスト比較についても内訳は公表されておらず、個々のカードとラック全体のメモリー容量の数値にも説明が必要だ。
性能評価ラボが紹介した各種実演からは、同社の主張をより詳しく把握できる。マルチメディア生成の小幅な向上から、推薦処理のスループットの大幅な増加まで、タスクごとに異なる改善が示されている。購入を検討する側にとって重要なのは、自社のサービスが実際に処理するタスクでの比較だ。
長文処理と初回応答の高速化
同社のラボによると、コンテキスト長が64Kの場合、Tiangai 300のアテンション性能はH200の1.05倍に達した。アテンションとは、入力のどの部分が相互に重要なのかをモデルが判断するのに役立つ処理だ。コンテキスト長64Kは、モデルが約6万4,000トークンを処理することを意味する。
同じコンテキスト長でGLM-5.3を動かした場合、Iluvatar CoreXは、ユーザー体験を同等に保ちながら、H200の1.15倍のスループットを達成したと主張した。これは、テストしたMixture of Experts(専門家混合)モデルの処理で15%の向上に当たる。Mixture of Expertsモデルは、すべてのトークンに対して全ネットワークを使うのではなく、選択した専門ネットワークに処理を振り分ける。
コンテキスト長が8Kから128Kに及ぶAIエージェントの処理では、最初の出力トークンが生成されるまでの待ち時間を約10%から30%短縮したと同社は報告した。長い文書を読み込んだり、複雑な依頼を処理したりした後、アシスタントが回答を始めるのを待つ人にとって重要な指標だ。
画像と動画の生成も実演の一部を占めた。同社は、H200と比べてマルチモーダル生成のスループットが約2%から5%向上したと報告した。オンライン検索、広告、推薦の処理では、推薦推論のスループットが21%高く、軽量な計算処理のレイテンシが26%低いと主張した。
学習性能の比較対象は別のNvidia製品
学習の実演では、約320億のパラメーターを持つモデルQwen3-32Bを8基のGPUサーバーで動かした。パラメーターとは、モデルがパターンを学習するため、学習中に調整する数値だ。Iluvatar CoreXによると、カード1基当たりの実効スループットはNvidiaのH100の1.33倍に達した。
したがって、この学習実演で報告された優位性は33%で、比較対象のチップはH100だった。イベント内の別の推論結果ではH200が使われている。数値を正しく理解するには、比較対象となる製品を区別することが欠かせない。
学習システムはFP8精度で動作した。FP8は数値を8ビットで表現し、より多くのビットを使う形式と比べて、移動・処理するデータ量を減らす。AI学習ソフトウェアは、学習の品質を保つため、この低い精度を慎重に扱う必要がある。
Iluvatar CoreXはまた、フル負荷で長時間稼働させた際のステップ時間の変動が0.43%だったと報告し、Hopperベースの基準システムの0.76%と比較した。ステップ時間とは、繰り返し行う作業の1単位を完了するのに必要な時間だ。時間が安定していれば、稼働中のシステムがどれだけの作業を完了できるか、運用者が見積もりやすくなる。
7月の発表から10月の実演へ
Tiangai 300は2026年7月、世界人工知能大会で正式に発表された。同社のTianshuアーキテクチャを採用し、新世代のTensor Coreを搭載、グラフィックスメモリーは144GBとされている。
このプロセッサは、スカラー、ベクトル、テンソル演算に対応する。簡単に言えば、それぞれ個々の数値、数値のまとまり、より大きな数学的配列を扱う。対応する数値形式にはFP4、FP8、FP16、BF16があり、ソフトウェア開発者は速度、メモリー使用量、数値精度に応じて選択できる。
同社が示した主な公開実績は、数カ月にわたる。
- 2026年7月:世界人工知能大会でTiangai 300を発表。
- 2026年7月:上海電気集団が、H200とのスループット比較に用いられた第三者テストを完了。
- 10月のメディアイベント前:中国国際工業博覧会でIXL144ラック設計を公開。
- 2026年10月28日:上海でメディア向けにTiangai 300ハードウェアのライブ実演を公開。
10月のイベントでは、製品の紹介がアーキテクチャの説明から、具体的な負荷を動かすシステムの実演へと移った。同社が説明する導入規模は、単体のアクセラレータカードから8基搭載サーバー、さらに大型のIXL144システムまで広がっている。
144基のGPUを搭載するラック
Iluvatar CoreXによると、IXL144は標準ラック1台に144基のGPUと18基のCPUを搭載し、GPUメモリーの合計は約10.1TBとなる。同社は、単一ラックに収めた業界最高密度のGPUスーパーノードだと説明した。スーパーノードは、多数のプロセッサを近接して接続し、大規模な処理で協調できるようにしたシステムだ。
Tiangai 300のカード1基当たり144GBという仕様と、ラック全体で10.1TBとする記載については、構成の内訳をより明確にする必要がある。カード144基に144GBを掛けると、容量の数え方の違いを考慮する前でも20,736GBとなる。ラックの説明ではカード構成と、実際の処理に利用できるメモリー容量を明示する必要がある。
Iluvatar CoreXは、主要な海外製システムと比べ、有効トークン100万個当たりのコストを約40%削減できると見積もっている。有効トークンとは、有用な作業として数えられる出力を指す。AIサービスを販売する事業者にとって、この指標はハードウェアへの支出と、生成された実用的な出力の量を結び付ける。
40%の削減は、基準システムで100単位かかる作業を60単位で行えることを意味する。実際の節約額は、機器価格、消費電力、ソフトウェア、処理内容、GPUをどれだけ継続的に稼働させられるかによって変わる。
同社はまた、次世代ピアツーピア接続エンジンの目標として、接続領域内の単一転送にかかる時間を3~5マイクロ秒から1マイクロ秒に短縮すると説明した。複数のGPUがモデルの異なる部分を保持し、データを繰り返しやりとりする場合、通信の高速化が役立つ。
異なるチップ間でAI処理を分担
Iluvatar CoreXの異種構成による導入方式では、推論の各処理を異なる種類のプロセッサに割り当てる。同社のAFD分離方式では、Tiangai 300がプリフィル段階全体とデコード中のアテンション計算を担う。パートナー企業のXPUはフィードフォワードの専門ネットワークを処理する。
XPUは、別の種類の計算アクセラレータを広く指す呼称だ。基本的な考え方は、共通のスケジューラーが全体の処理を調整しながら、それぞれのプロセッサが得意とする作業を割り当てることにある。フィードフォワードネットワークは、言語モデル内部の数学的処理を担うもう一つの主要な部分だ。
同社は、統合スケジューリングの下でデコード推論のレイテンシを60%削減したと報告した。これは、H200に対するスループット5%向上という主要結果とは別のシステム構成で、測定指標も異なる。
同社のAI・アクセラレーテッドコンピューティング部門責任者、Shan Tianyi氏は、今後のAIコンピューティングシステムは、あらゆるタスクで単一種類のプロセッサに依存するのではなく、異なるチップを効率よく運用することにかかっていると述べた。AFDの実演では、GPUとパートナー企業のアクセラレータを組み合わせることで、この戦略を具体化した。
ソフトウェアの主張は導入期間の短縮が焦点
Iluvatar CoreXはまた、導入や最適化の一部を自動化することを目的とした「AI for AI」ソフトウェアスタックを紹介した。同社によると、環境構築にかかる時間は1時間から10分に短縮され、手作業の回数は数十回から1回に減った。
ある大規模モデルの最適化作業では、作業期間を7日から2時間未満に短縮し、性能は従来のほぼ2倍に近づいたと報告した。これらの例は、ハードウェア上でモデルを効率よく動かすために必要なエンジニアリング作業に関するものだ。
同社は、GPU計算ルーチンの開発に使う言語FlyDSLとの緊密な統合も主張した。コンパイル速度が90%以上向上したとし、従来は10人が1日かけていた作業を、1人で数時間以内に完了できるようになったと説明した。
プロセッサには高性能な演算ハードウェアだけでなく、ソフトウェアの対応も欠かせない。モデル、数学ライブラリー、導入ツールが連携して動作する必要がある。今回のソフトウェア実演は、新しいGPUを実用的なサービスとして稼働させるまでに、顧客がどれほどのエンジニアリング作業を必要とするかを示すものだ。
TY1200でロボット分野にも展開
上海のイベントでは、AI PCや、物理世界を認識して行動するロボットなどの身体性知能を対象とする別のプロセッサ、Tongyang TY1200も披露された。公称の高密度演算性能は300 TOPS、すなわち毎秒300兆回の演算だ。高密度演算は、ゼロ値を含む計算を省略する方法に頼らずに数える処理量を指す。
Iluvatar CoreXは、Qwen3.8-27BとQwen3.6-35B-A3Bを使ったテストで、TY1200がNvidia Thor T5000の1.2倍の性能に達したと主張した。物理AIのシナリオでCosmos-R2-2BとCosmos-R2-8Bを使った場合は、それぞれThor T5000の基準性能の158%、180%に相当する性能を報告した。
同社はまた、TY1200がMuJoCo-Warpを使ったGPUアクセラレーション対応の物理シミュレーションを実行できると説明した。これにより、ロボット開発システムで動きをシミュレーションし、制御方策を学習させ、動作をローカルで検証できる。制御方策とは、ロボットが動き方を決める際に使う、学習済みの指示体系だ。
報告された用途には、医療機関の受診時に人を支援するロボット、産業用ビジョン、来訪者案内が含まれる。後継機として計画されているTY2000の演算性能目標は600Tとされる。これらの製品によって同社の戦略は、大規模AIサーバーから、ユーザーや機械の近くで稼働する機器へと広がる。
要点
- Iluvatar CoreXは2026年10月28日、上海でTiangai 300のハードウェアを実演した。
- 同社は、上海電気集団によるテストを根拠に、カード1基当たりのスループットがNvidia H200の1.05倍に相当するとした。
- 8基のGPUを使ったQwen3-32Bの学習実演では、FP8精度でカード1基当たりH100の1.33倍のスループットを達成したと報告した。
- 主要な第三者ベンチマークの詳細な測定方法は公表されていない。
- IXL144ラックは144基のGPUと18基のCPUを搭載し、有効トークン100万個当たりのコストを40%削減できると主張している。
- GPUとXPUで処理を分担する別の構成では、デコードのレイテンシを60%削減したと報告した。
- イベントではソフトウェアの自動化や、ローカルAI、ロボットシミュレーションにおけるTY1200の用途も取り上げられた。